Um novo estudo comparativo analisa as APIs de inferência com menor latência para agentes de voz e sistemas em tempo real, estabelecendo a métrica Time to First Token (TTFT) como ponto de partida para a avaliação de desempenho nessa categoria crescente de aplicações de inteligência artificial.
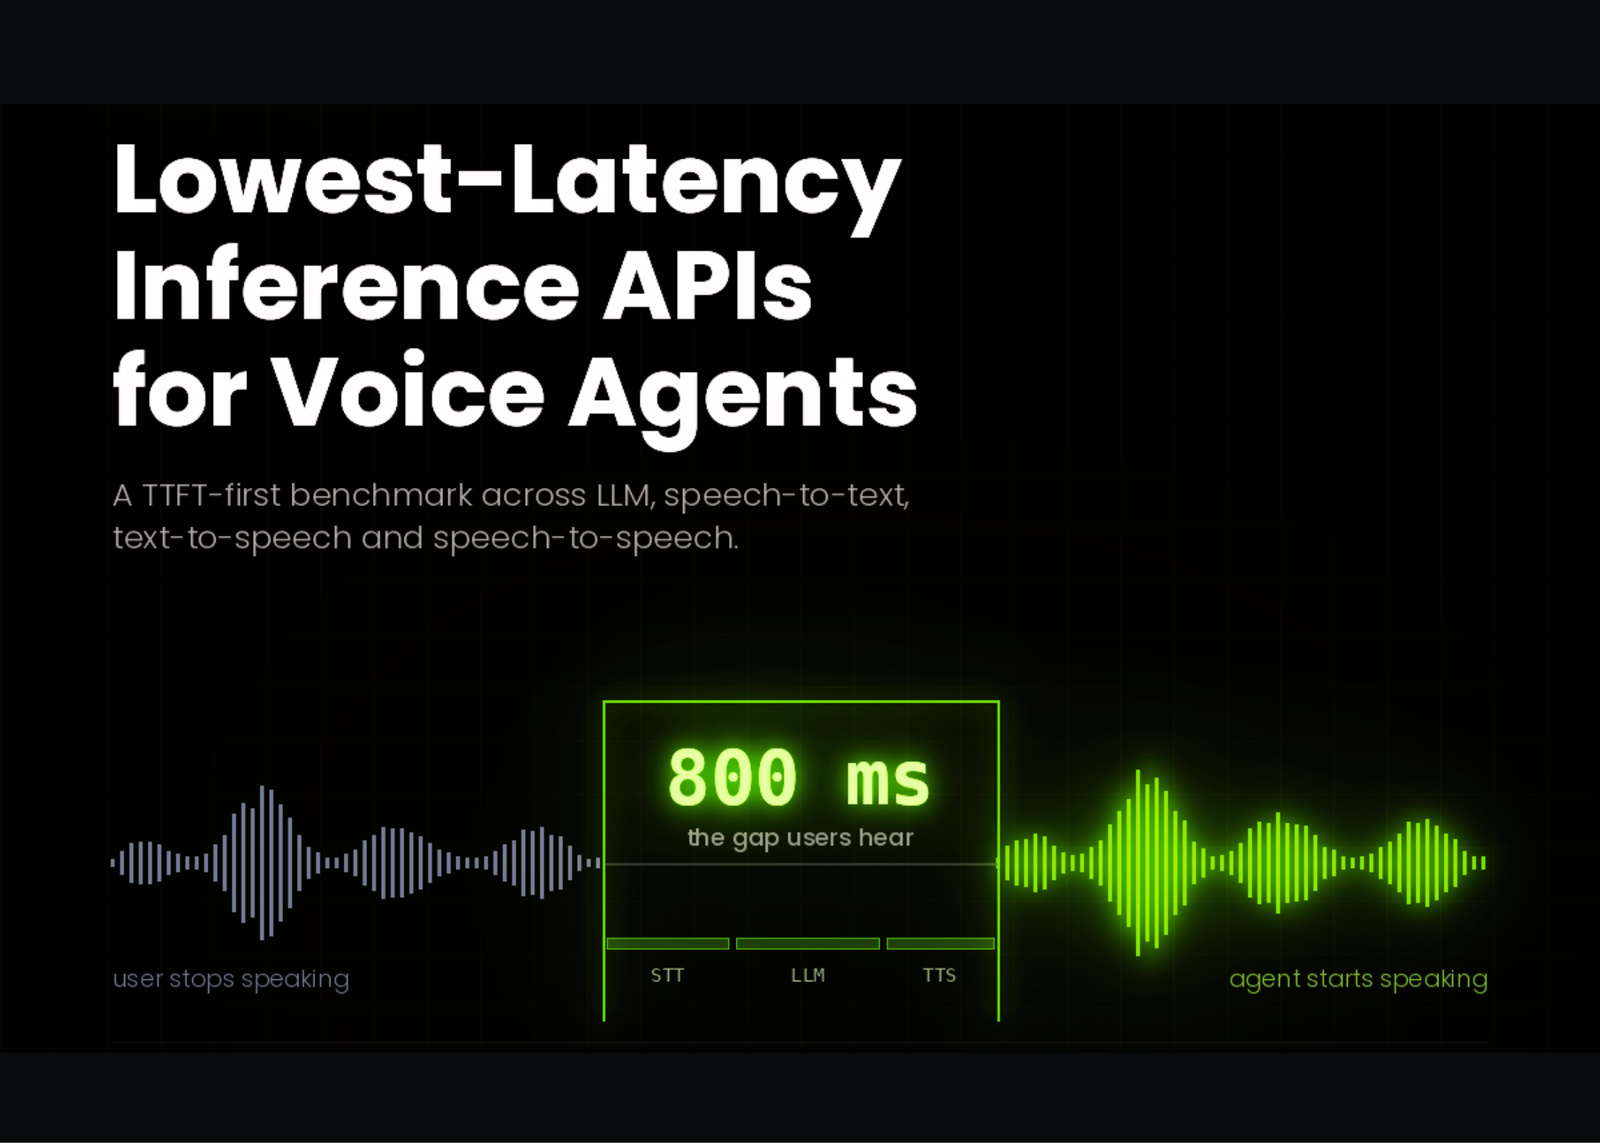
O benchmark, que teve seus dados verificados em 30 de agosto de 2026, examina múltiplas camadas da arquitetura de voz, incluindo modelos de linguagem grande (LLM), sistemas de reconhecimento de fala (speech-to-text), síntese de fala (text-to-speech) e conversão direta de fala (speech-to-speech).
O problema da latência em agentes de voz
Segundo a análise, agentes de voz falham por limitações de latência muito antes de falharem por inteligência insuficiente. Isso significa que a velocidade de resposta é um fator crítico que determina a experiência do usuário, frequentemente mais importante que a qualidade das respostas geradas pelo modelo de IA.
O Time to First Token, que mede o tempo decorrido até a geração do primeiro token de resposta, emergiu como a métrica predominante entre equipes de desenvolvimento na escolha de provedores de APIs de inferência.
Escopo e metodologia do benchmark
O estudo cobre a cadeia completa de processamento necessária para sistemas de voz em tempo real:
- LLM (Large Language Models): modelos de linguagem base
- Speech-to-text: transcição de áudio para texto
- Text-to-speech: geração de áudio a partir de texto
- Speech-to-speech: processamento direto de voz para voz
Os dados apresentados são classificados conforme sua origem: medições independentes, informações publicadas pelos fornecedores ou métricas fornecidas pelos próprios provedores em seus produtos.
Importância para o mercado de IA
O trabalho aborda uma questão prática essencial para o desenvolvimento de aplicações de IA conversacional. Enquanto a inteligência do modelo é importante, a percepção de responsividade por parte do usuário depende fortemente da latência geral do sistema.
Empresas que desenvolvem agentes de voz, assistentes virtuais e sistemas de atendimento automatizado têm se deparado com esse desafio: escolher uma API baseando-se apenas em TTFT é o ponto de partida correto, mas não deve ser o único critério de decisão. Uma análise mais profunda das diferentes camadas da pilha de processamento de voz é necessária para otimizações efetivas.
O benchmark oferece uma comparação estruturada que permite aos desenvolvedores compreender onde os gargalos de latência ocorrem e qual provedor de API oferece o melhor desempenho para seus casos de uso específicos.
Fonte: MarkTechPost
Sobre o autor