A Exa lançou o Agent Ultra, o modo de máximo esforço de sua Exa Agent API, projetado para pesquisas que precisam rodar até o limite: construção de listas grandes, enriquecimento de entidades e questões que requerem milhares de fontes. O sistema está disponível hoje como API hospedada, configurando o parâmetro de esforço como “ultra”.
Como funciona o Agent Ultra
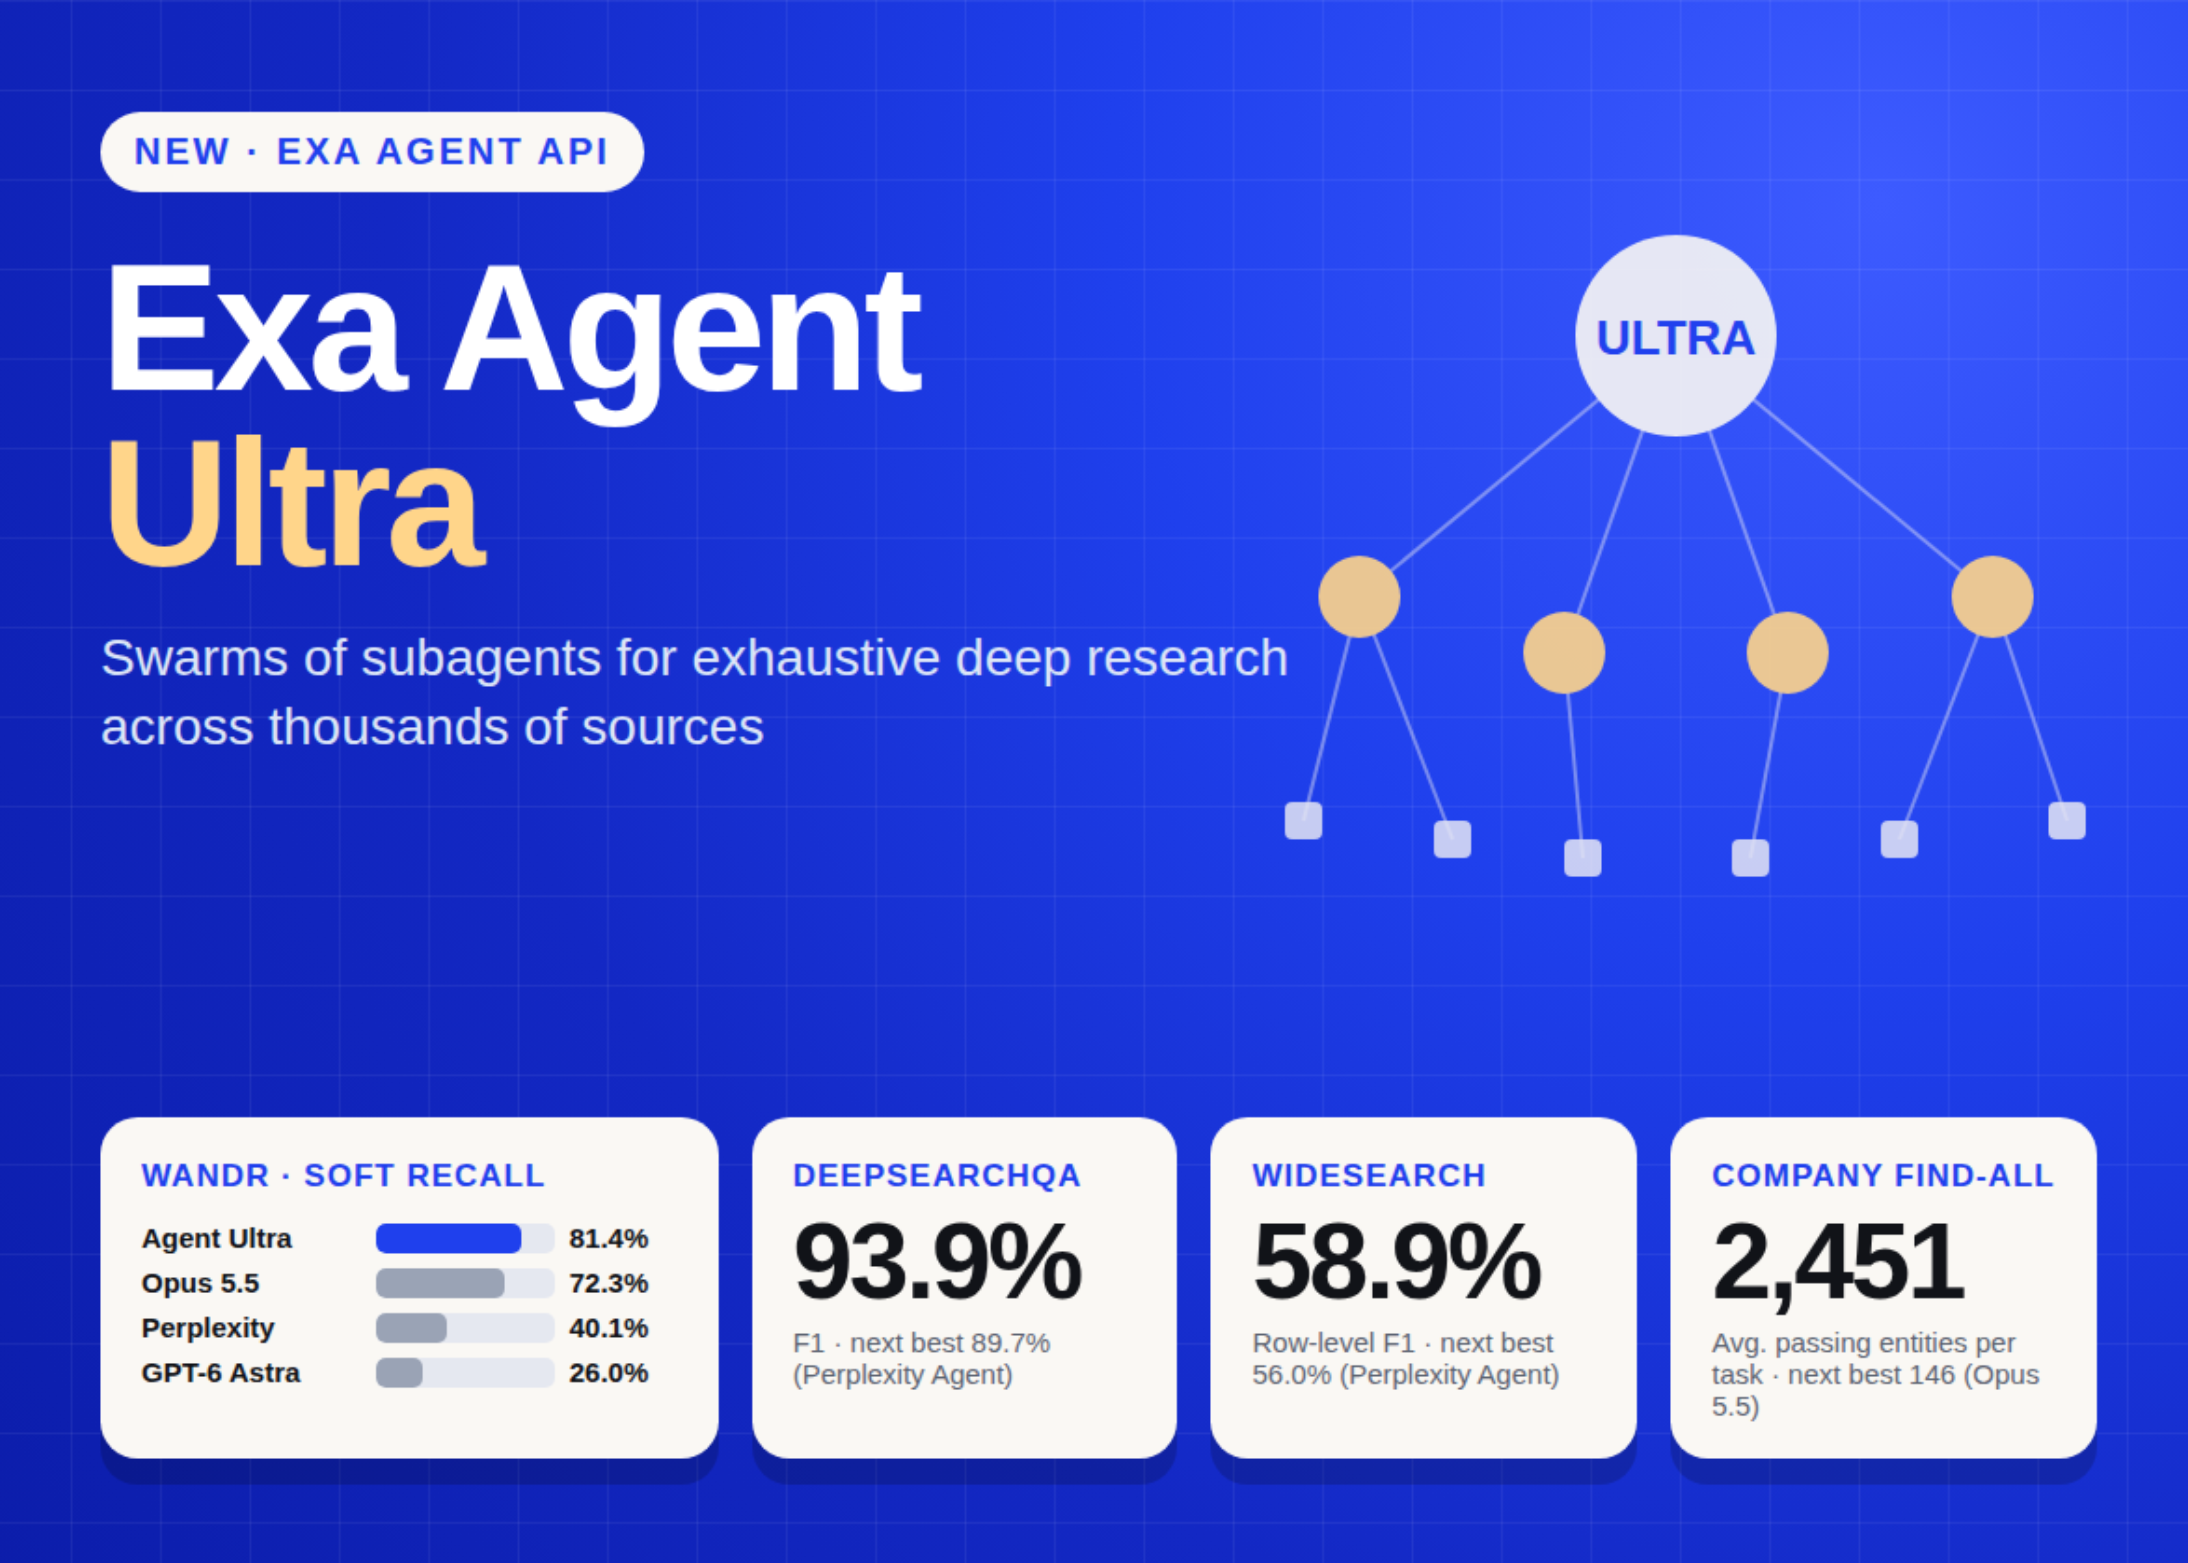
O Agent Ultra divide tarefas complexas em subtarefas e atribui subagentes para pesquisar vários domínios simultaneamente. A arquitetura do sistema roteia modelos de fronteira (mais capazes) para etapas que delas precisam e modelos mais rápidos onde são suficientes. Ultra é o modo que consome mais recursos computacionais da plataforma.
De acordo com a documentação oficial do Agent Ultra, o sistema executa por mais tempo que qualquer outro nível de esforço para retornar resultados mais completos. Execuções típicas de tarefas complexas terminam em aproximadamente 30 minutos, enquanto tarefas muito difíceis podem levar até 3 horas.
O Agent Ultra utiliza o endpoint padrão de execução do Agent, suportando schemaOutput, input.data e streaming. Também oferece compatibilidade com OpenAI, permitindo configurar reasoning.effort como “ultra” no endpoint /responses tanto em modo streaming quanto em background. Usuários podem testar o sistema no Exa API Playground.
Desempenho em benchmarks
A Exa relatou que o Agent Ultra supera Opus 5.5, GPT-6 Astra e Perplexity Agent—cada um em seu modo de máximo esforço—em 4 benchmarks de pesquisa. Os resultados alcançados foram:
- WANDR: 81,4% de soft recall (conforme dados da Exa), com ganho de 12,6% sobre Opus 5.5 a apenas metade do custo por tarefa
- DeepSearchQA: ganho de 4,7% sobre Perplexity, com custo 46% inferior ao de GPT-6 Astra por tarefa
- WideSearch: ganho de 5,2% sobre Perplexity, com menor custo por tarefa entre os 4 sistemas
- Company Find-All: ganho de 1.579% sobre Opus 5.5 com menor custo por entidade encontrada
Importante ressaltar que todos esses resultados são reportados pela Exa e ainda não foram reproduzidos independentemente por terceiros. A WANDR é o benchmark de Perplexity com 500 tarefas de coleta de dados ampla e profunda e possui um harness aberto. A Exa adaptou o avaliador compartilhando a lógica de avaliação upstream, substituindo a ferramenta de conteúdo por Exa, alterando a lógica de transporte e usando gpt-6-luna como juiz. Onde fornecedores publicaram resultados neste harness, a Exa reporta esse número; caso contrário, executou o benchmark internamente. A DeepSearchQA é o benchmark multietapas de 900 prompts do Google DeepMind; WideSearch testa coleta ampla de informações. A Exa avaliou até 200 tarefas cada para WANDR e DeepSearchQA, e 100 cada para WideSearch e Company Find-All.
Recursos e casos de uso
O Agent Ultra está disponível apenas como API hospedada—não é código aberto nem pode ser auto-hospedado. A plataforma identifica três grupos de usuários alvo:
- Provedores de modelos: assemblar dados de treinamento, como todos os papers e repositórios implementando uma técnica específica, verificando critérios como “pesos liberados, não apenas uma API”
- Serviços financeiros: construir mapas de diligência, executar pesquisa KYC em registros e documentos judiciais, monitorar sinais de portfólio
- Equipes go-to-market: construir listas de contas e enriquecer linhas com campos de contexto, cada um apoiado por URL citada
O sistema também pode expandir uma lista existente. Usuários passam as linhas que já possuem e são excluídas dos novos resultados.
Preços e configuração
O Agent Ultra é cobrado nas taxas padrão de uso do Agent, até um máximo padrão de US$ 20 por execução. Execuções que terminam mais cedo custam menos. O orçamento pode ser configurado via parâmetro maxCostDollars, aceitando de US$ 1 a US$ 100. A duração máxima é controlada por maxDurationSeconds, aceitando de 300 a 10.800 segundos (até 3 horas).
Uma chamada stop encerra uma execução mais cedo, mantém seus resultados e cobra apenas pelo uso até aquele ponto. Os helpers de polling do SDK expiram após 1 hora por padrão, portanto é necessário definir um timeout mais longo ou fazer streaming de eventos para execuções prolongadas.
Análise Panorama IA
O lançamento do Agent Ultra representa um movimento claro da Exa em direção a tarefas que exigem profundidade e escala simultâneas. A arquitetura de orquestração de subagentes e roteamento inteligente de modelos endereça um problema real: nem toda etapa de pesquisa exige modelos de fronteira caros. A decisão de oferecer apenas como API hospedada—sem opção de auto-hospedagem—mantém controle sobre execução e custos, aspecto crítico quando o máximo de esforço pode consumir até 3 horas.
Os benchmarks reportados mostram ganhos incrementais consistentes sobre concorrentes em “máximo esforço”, mas a ressalva é importante: todos são dados da própria Exa. O WANDR usa gpt-6-luna como juiz, não Opus 5.5 ou o modelo original do benchmark. O gap absoluto de 9,1 pontos percentuais na WANDR frente ao Opus 5.5 é menor que o ganho relativo de 12,6% sugeriria. Para equipes financeiras e de go-to-market, a combinação de custo controlável (até $20/execução, ajustável para $1–$100) com tempo previsível (30 minutos típicos) torna a proposta concreta. O ponto fraco é a ausência de reprodução independente dos benchmarks—usuários em produção deverão validar os ganhos em seus casos específicos antes de substituir sistemas em uso.
A compatibilidade com formato OpenAI no endpoint /responses reduz fricção de integração, aspecto importante quando se move esforço pesado de pesquisa para infraestrutura dedicada. Observar: o parâmetro default de timeout do SDK (1 hora) é insuficiente para execuções de 3 horas, exigindo configuração manual—um detalhe operacional que pode gerar falsos negativos se não documentado internamente.
Fonte: MarkTechPost
Sobre o autor