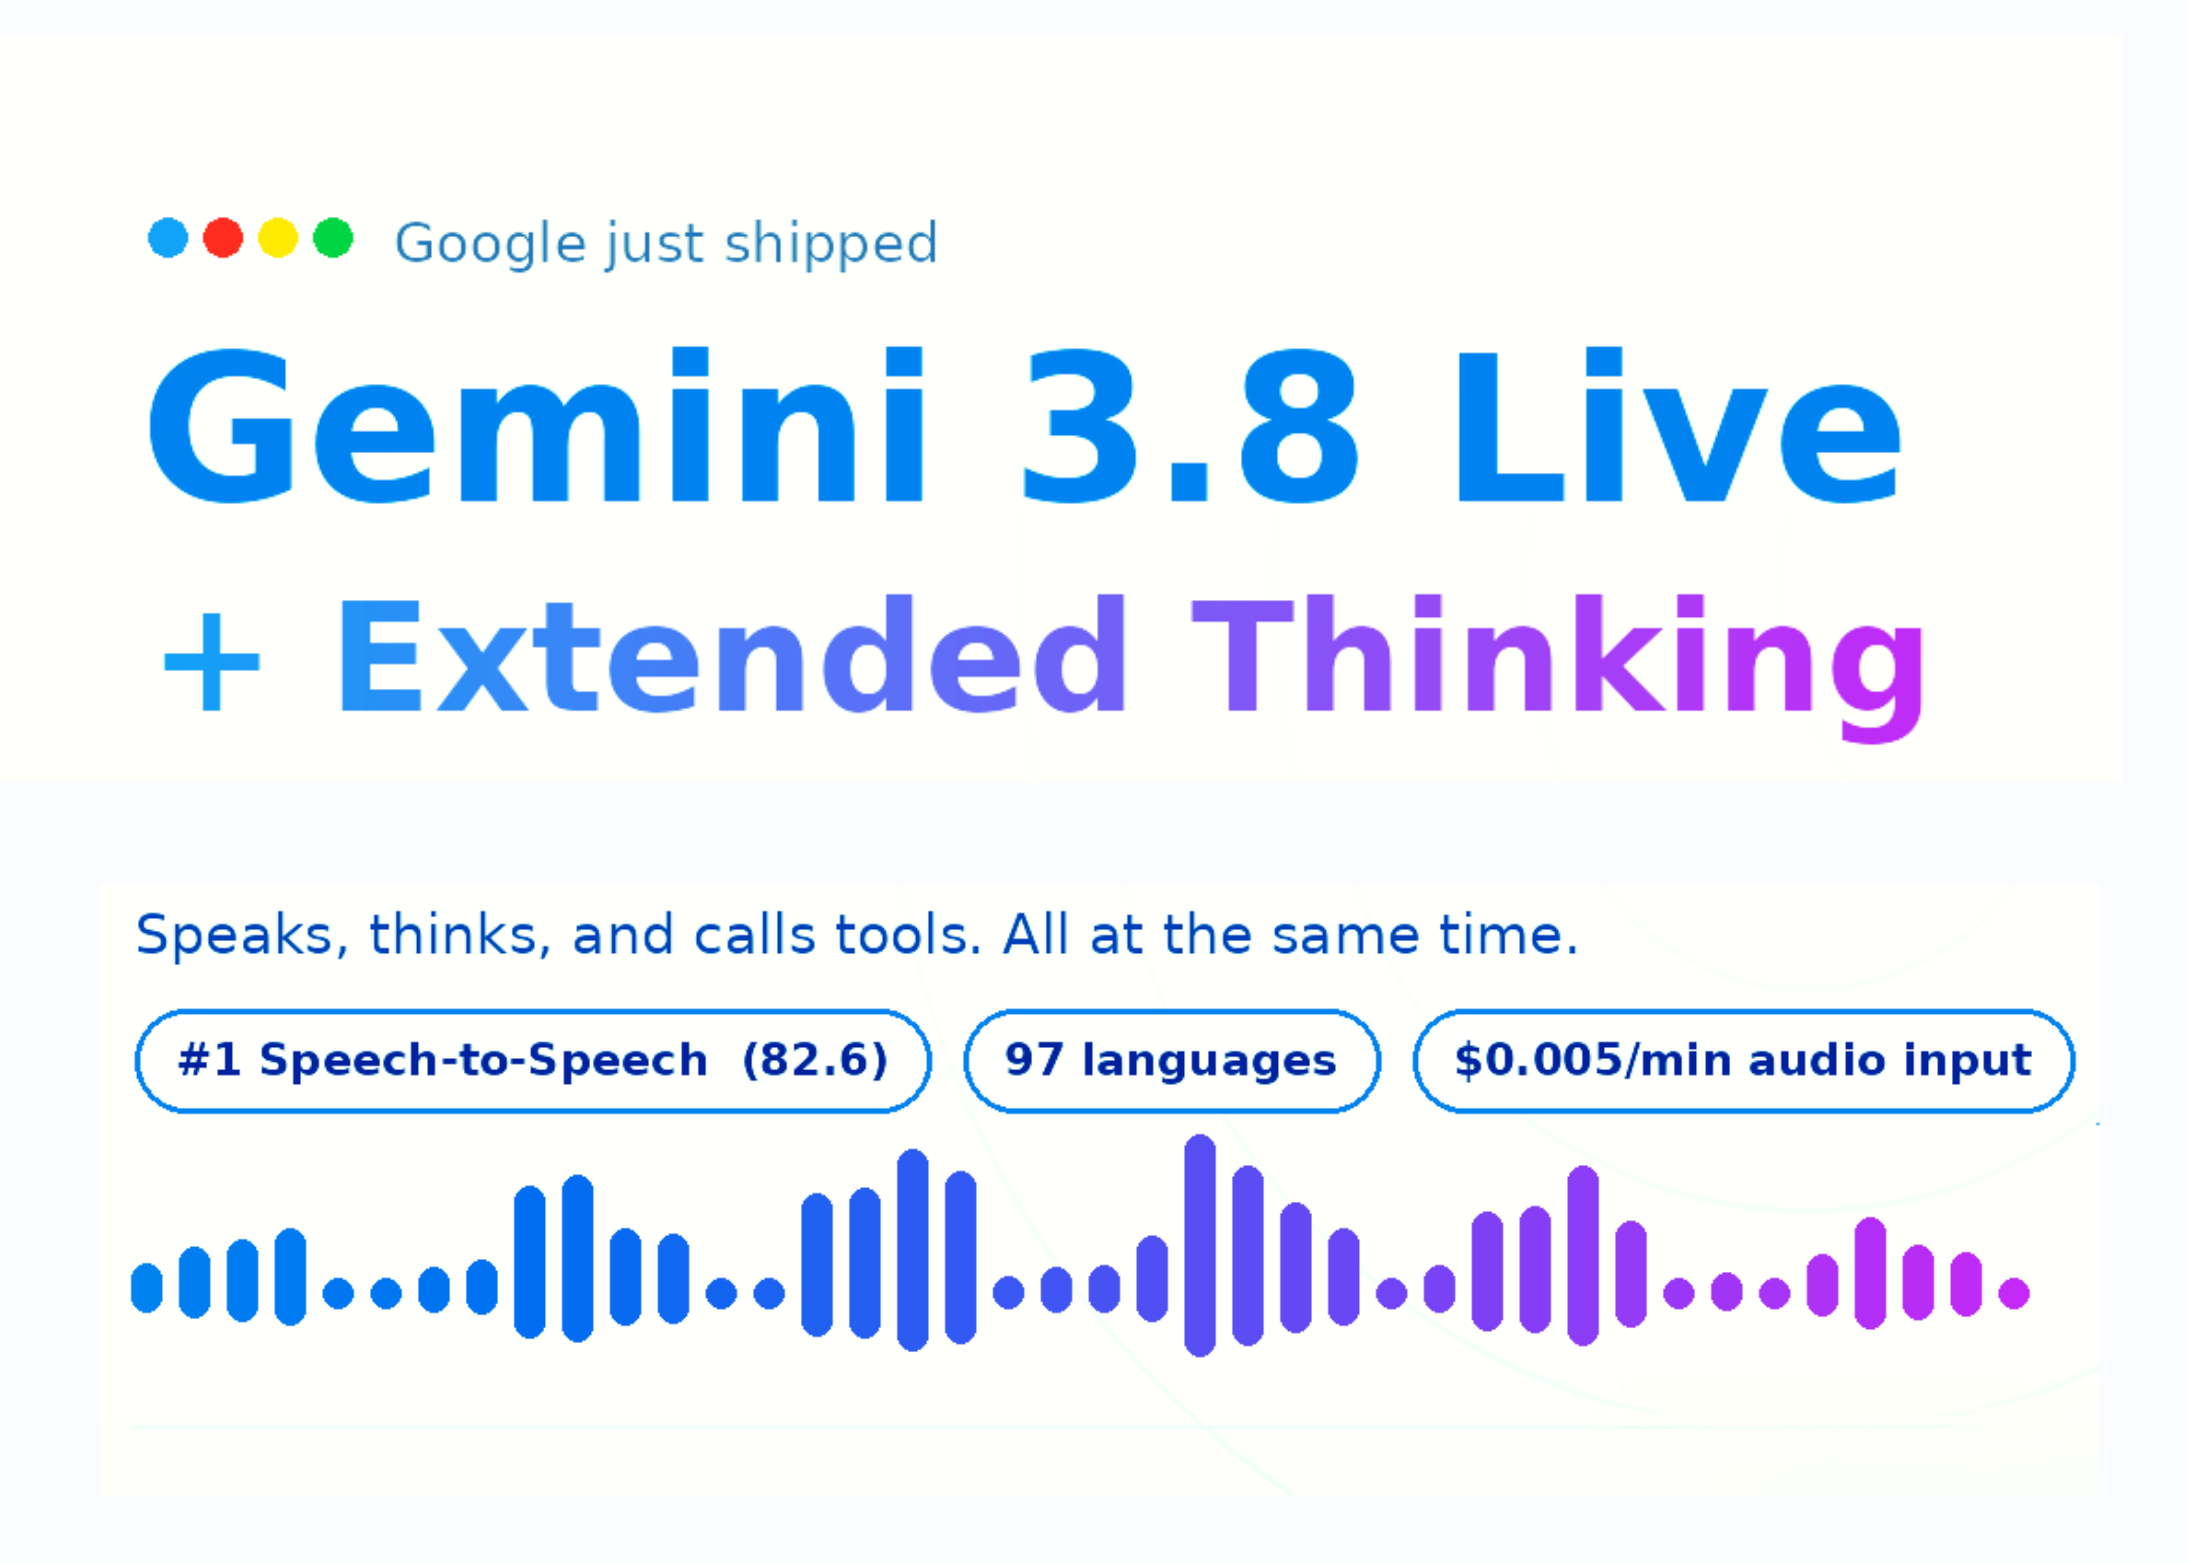
A Google apresentou Gemini 3.8 Live e Gemini 3.8 Live Extended Thinking, seus modelos de diálogo em tempo real mais avançados até o momento. Os dois modelos são nativamente speech-to-speech, projetados para agentes de voz que funcionem em produção sem interrupções conversacionais. Estão disponíveis hoje pela Gemini API e Google AI Studio, com preço de $0,005 por minuto para entrada de áudio.
Capacidades principais dos novos modelos
Os dois modelos compartilham um conjunto de cinco capacidades centrais que os diferenciam de abordagens tradicionais baseadas em pipelines em cascata, que encadeiam reconhecimento automático de fala, um modelo de linguagem e síntese de texto em fala.
- Chamadas de função assíncronas: executam APIs e chamadas de ferramentas em segundo plano enquanto as respostas de áudio continuam fluindo para o usuário
- Contexto visual: processam entradas visuais em tempo quase real, permitindo que agentes entendam o que usuários falam e veem simultaneamente
- Precisão alfanumérica: interpretam com precisão códigos de confirmação, números de sinistro e dados técnicos, pontos críticos de falha em sistemas de voz tradicionais
- Suporte multilíngue: detectam automaticamente e fazem transição entre 97 idiomas durante a conversa, mantendo consistência de sotaque
- Atualizações incrementais de conteúdo: mesclam áudio em tempo real com dados estruturados para retornar respostas contextualizadas
O Extended Thinking adiciona um nível de raciocínio configurável que opera em segundo plano. Enquanto raciocina, o modelo fala simultaneamente, usando sinais verbais iniciais como “deixe-me verificar isso” para reconhecer prompts. Em seguida, narra o progresso passo a passo enquanto tarefas de longa duração são executadas. Nas demonstrações da Google, o modelo converte esboços mais feedback de voz em componentes React funcionais e coordena reservas com múltiplas etapas.
Desempenho e benchmarks
Gemini 3.8 Live Extended Thinking ocupa o primeiro lugar no Speech to Speech Quality Index da Artificial Analysis com pontuação de 82,6. O modelo também alcança 68,6% no benchmark τ-Voice e 35,1% no τ-Voice-banking da Sierra, métricas que medem conclusão de tarefas com raciocínio. No Big Bench Audio, um teste de raciocínio específico para modelos de áudio, obtém 97,7%.
Gemini 3.8 Live, a variante otimizada para escala e eficiência de custo, conquistou o segundo lugar na Speech Agent Arena, uma avaliação de preferência humana. Em ServiceNow’s EVA-Bench, os modelos deslocam a fronteira de Pareto para fluxos de trabalho complexos, equilibrando precisão de tarefa com qualidade conversacional.
Modelo de negócios e integração
Ambos os modelos têm preço fixo de $0,005 por minuto para entrada de áudio e $0,018 por minuto para saída de áudio. A Google informa que essa estimativa baseia-se em $3 por milhão de tokens de entrada e $12 por milhão de tokens de saída pela Live API.
Os modelos são hospedados, não oferecendo uma opção de pesos abertos para auto-hospedagem. Desenvolvedores podem construir integrações através de partners da Live API que lidam com infraestrutura de streaming de mídia em tempo real. A Google lista oito parceiros de integração: Agora, Fishjam, LangChain, LiveKit, Pipecat, Vercel e Vision Agents. Além disso, a empresa está em parceria com Salesforce, Genspark e Lumeris, que citam latência, fluidez e capacidade de chamada de ferramentas como diferenciais.
Toda audio gerado pelos modelos carrega a marca d’água imperceptível SynthID do Google DeepMind, técnica de identificação de conteúdo gerado por IA. Exemplos de aplicações estão disponíveis no GitHub da Google.
Contexto técnico e diferenças entre variantes
Gemini 3.8 Live é construído para escala e eficiência de custo, combinando inteligência conversacional com diálogo fluido e ancoragem visual. Gemini 3.8 Live Extended Thinking é construído para tarefas de alta complexidade, adicionando inteligência aumentada e raciocínio multietapas enquanto fala.
Ambos estendem a família Gemini Audio que a Google expandiu no mês anterior com Gemini 3.5 Transcribe. O lançamento endereça uma lacuna específica: agentes de voz que raciocinem e executem ferramentas sem quebrar o fluxo conversacional. Os modelos tradicionais costumam interromper a conversa durante processamento de tarefas ou deixam cair contexto visual. A abordagem nativa speech-to-speech elimina etapas intermediárias de conversão, reduzindo latência e pontos de falha.
Limitações e considerações de implantação
Embora os modelos estejam em produção, há limitações importantes a considerar. Não há opção de hospedagem própria—todos os processamentos ocorrem nos servidores da Google. Isso implica dependência de conectividade de rede e conformidade com políticas de privacidade de dados da empresa. O suporte a 97 idiomas, embora extenso, não cobre linguagens menos representadas em dados de treinamento.
O custo por minuto, embora competitivo para produção, deve ser avaliado contra volume de uso. Uma conversa média de dez minutos custaria $0,05 a $0,18 em entrada e saída de áudio, valor que escala rapidamente em plataformas com milhares de interações simultâneas.
Análise Panorama IA
O lançamento do Gemini 3.8 Live marca uma transição significativa no mercado de agentes de IA por voz. A capacidade de executar ferramentas e APIs em segundo plano sem interromper a conversa resolve um problema prático antigo em sistemas de voz: a sensação de “espera morta” enquanto o sistema processa. Isso importa porque conversas naturais não têm pausas vazias—quando um humano diz “deixe-me verificar”, continua falando ou oferece feedback inteligível.
Para quem constrói agentes de suporte ao cliente, booking de reservas ou atendimento bancário, essa fluidez reduz frustração do usuário final. A integração com parceiros como LangChain e Vercel sugere que o desenvolvedor médio pode começar sem expertise profunda em streaming de mídia ou orquestração de baixa latência.
A ressalva importante é que os modelos são hospedados apenas. Empresas com restrições rigorosas de residência de dados ou que precisam processar informações altamente sensíveis sem envio a servidores da Google não têm opção de auto-hospedagem. Além disso, os benchmarks citados (Speech to Speech Quality Index, Big Bench Audio) são métodos de avaliação, mas não substituem testes em cenários reais específicos de cada caso de uso.
O que observar a seguir: como a latência real em produção se comporta em conexões de rede variáveis, qual será a adoção entre desenvolvedoras concorrentes que usam modelos de voz alternativos, e se a Google expandirá opções de auto-hospedagem em camadas empresariais futuras.
Fonte: MarkTechPost
Sobre o autor