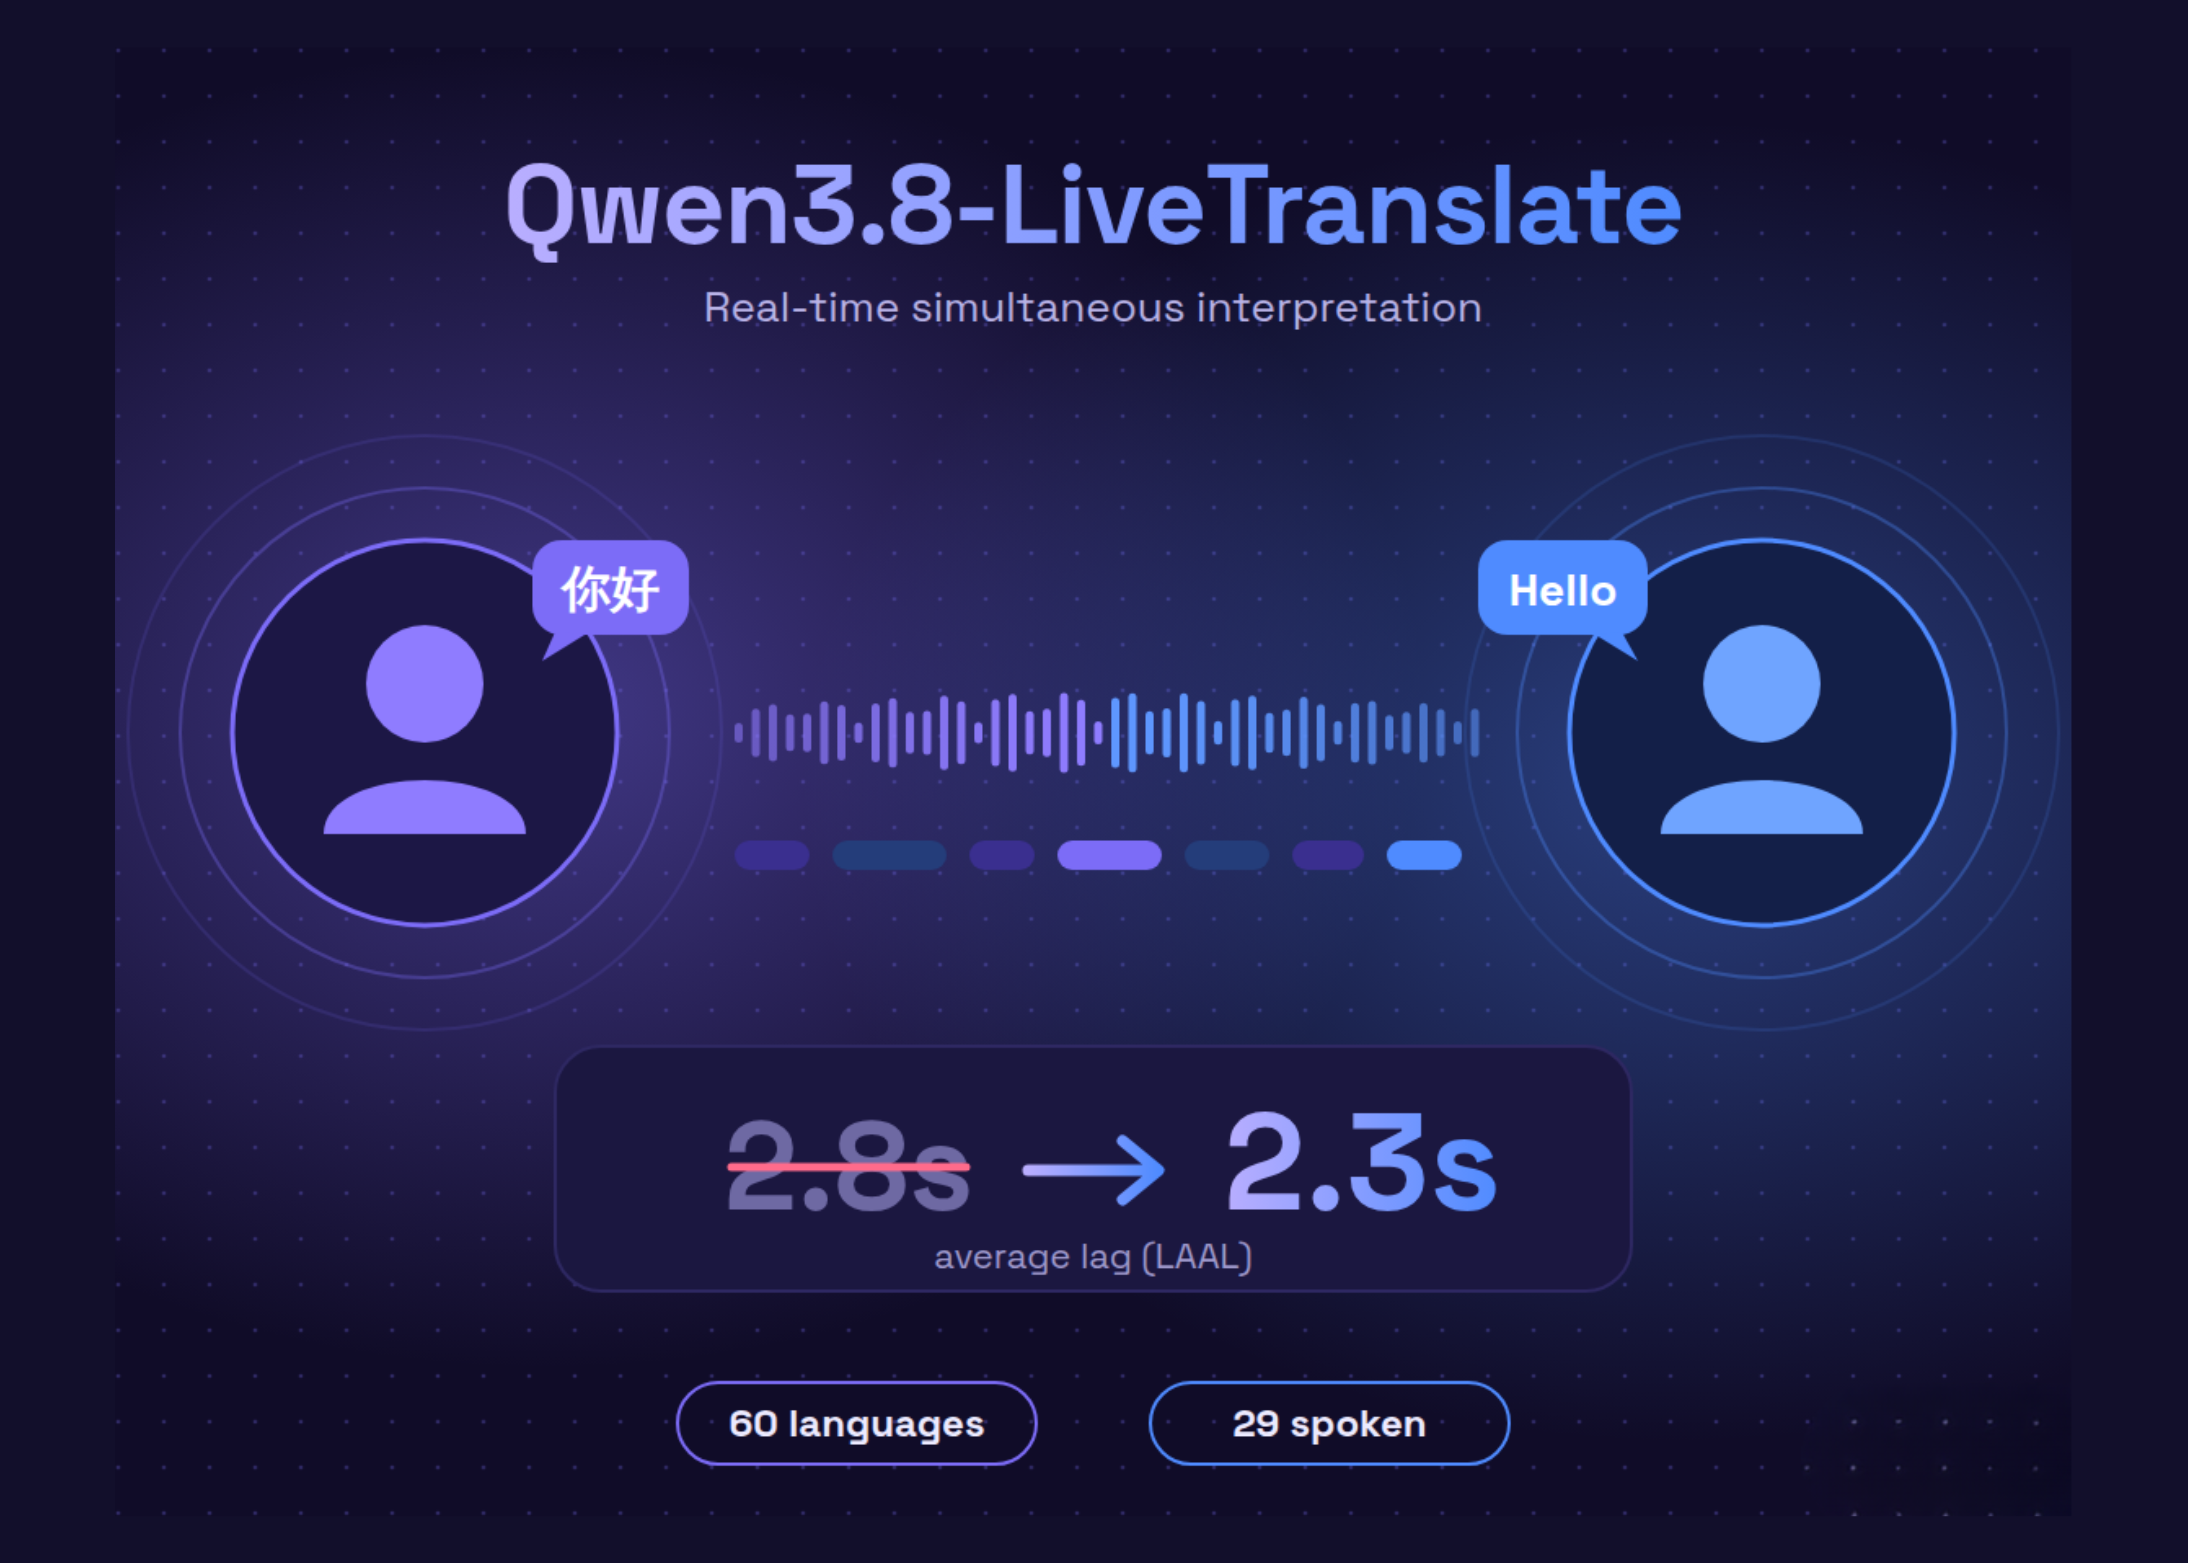
A Alibaba lançou o Qwen3.8-LiveTranslate, modelo de interpretação simultânea em tempo real que processa fala ao vivo, com suporte opcional a quadros de vídeo, e retorna texto e fala traduzidos enquanto o falante ainda está falando. A novidade central é uma nova arquitetura chamada Interleave, que reduz a latência média (LAAL) de 2,8 segundos para 2,3 segundos—uma redução aproximada de 18%. O modelo compreende 60 idiomas, fala 29 deles, e está disponível como API WebSocket no Alibaba Cloud Model Studio e QwenCloud.
A arquitetura Interleave e redução de latência
A interpretação simultânea opera sob um dilema fundamental: aguardar mais tempo fornece ao modelo contexto adicional, mas falar cedo reduz o atraso para o ouvinte. O Qwen3.8-LiveTranslate reconstrói esse equilíbrio por meio da arquitetura Interleave.
A métrica de latência utilizada é LAAL (Length-Adaptive Average Lagging), que mede a distância média entre a tradução e a fala original. Diferentemente de outras métricas, o LAAL evita recompensar sistemas que geram saída excessiva. A redução de 2,8 para 2,3 segundos é obtida pelo aprimoramento em três aspectos segundo a Alibaba: fidelidade (precisão do conteúdo), fluência (naturalidade da fala) e concisão (evitar redundâncias).
O modelo é baseado na pilha Qwen-Omni, aproveitando grandes volumes de dados multimodais, alinhamento cross-language e cross-modal, além de aprimoramentos visuais. A versão Flash também suporta tradução de áudio e vídeo offline, ampliando casos de uso além da interpretação ao vivo.
Capacidades de fala multi-falante e contexto de longa janela
O Qwen3.8-LiveTranslate incorpora dois recursos significativos para conversas complexas:
- Diarização de falante em tempo real: o modelo distingue falantes em conversas com múltiplos participantes e preserva a voz de cada um por meio de clonagem de voz mais estável. A API expõe modos de clonagem, incluindo modo sempre ativo que reclona antes de cada resposta em sessões multi-falante.
- Desambiguação de longo contexto: o modelo utiliza histórico de conversação para resolver nomes e terminologia. Um nome introduzido no início de uma reunião permanece consistente na tradução subsequente.
- Exibição bilíngue sincronizada: texto de origem e tradução aparecem na tela simultaneamente. Na API, a transcrição de origem é transmitida como eventos separados ao lado do fluxo de tradução.
Esses recursos endereçam um desafio prático em interpretação simultânea: manter coerência terminológica e identidade de falante em sessões longas, onde a qualidade degrada rapidamente sem contexto adequado.
Cobertura linguística e configuração técnica
O modelo compreende 60 idiomas. Dentre eles, consegue sintetizar fala em 29 idiomas, retornando áudio e texto. Os 31 idiomas restantes retornam apenas texto. A saída de áudio inclui chinês, inglês, árabe, alemão, francês, espanhol, japonês, coreano, hindi e outros.
As entradas aceitam áudio e imagens opcionais. Pistas visuais como movimentos labiais, gestos e texto visível na tela auxiliam em salas ruidosas e com palavras ambíguas. A documentação recomenda não enviar mais de 2 imagens por segundo. Times podem configurar hotwords que mapeiam termos de origem para traduções fixas no idioma alvo; a Alibaba recomenda não mais de 1.000 hotwords.
Desenvolvedores conectam via WebSocket Realtime API usando o ID de modelo qwen3.8-livetranslate-flash-realtime. O tipo padrão de detecção de ativação é speaker_detection. Clientes transmitem áudio continuamente e recebem respostas geradas pelo servidor. O padrão de áudio é PCM 16 kHz na entrada e PCM 24 kHz na saída. A voz padrão é Tina.
Preços e limitações operacionais
O modelo está disponível via API com preços variáveis por região. Em Singapura, o custo por 1 milhão de tokens é:
| Tipo de entrada/saída | Custo (Singapura, USD) | Custo (Pequim, USD) |
|---|---|---|
| Entrada de áudio | $7,50 | $5,653 |
| Entrada de imagem | $0,55 | $0,466 |
| Saída de texto | $20 | $14,133 |
| Saída de áudio | $30 | $22,613 |
Em termos de consumo, áudio de entrada consome 7 tokens por segundo, enquanto áudio de saída consome 12,5 tokens por segundo. Uma hora de fala como entrada e saída custa aproximadamente $1,54 em Singapura, antes de tokens de texto e imagem.
O contexto disponível é 53.248 tokens no total: 49.152 para entrada e 4.096 para saída. Os limites de taxa padrão são 10 requisições e 100.000 tokens por minuto. Conforme documentação do Model Studio, function calling, structured outputs, batch inference e fine-tuning não são suportados no modelo.
Análise Panorama IA
O lançamento do Qwen3.8-LiveTranslate marca um avanço em um problema notoriamente difícil: reduzir a latência em interpretação simultânea sem sacrificar qualidade. A redução de 2,8 para 2,3 segundos é modesta em número absoluto, mas significativa no contexto de interpretação, onde cada décimo de segundo afeta a experiência do ouvinte e a viabilidade de conferências multilíngues.
A arquitetura Interleave é apresentada como a inovação central, embora a fonte não detalhe sua implementação. O foco da Alibaba em diarização de falante e desambiguação contextual sugere que a firma reconhece limitações reais da geração anterior. Para usuários finais, isso significa melhor consistência em reuniões complexas, não apenas tradução mais rápida.
A disponibilidade como API-only via plataformas Alibaba estabelece uma barreira de entrada: não há modelo de download aberto, apenas acesso na nuvem. Isso contrasta com abordagens mais abertas de concorrentes e concentra uso em ecossistema Alibaba Cloud. O preço em Pequim significativamente menor que em Singapura reflete estratégia geográfica esperada.
Importa observar que a especificação não menciona testes comparativos públicos contra outros sistemas de interpretação simultânea. A métrica LAAL é válida, mas sem benchmark externo, a reclamação de melhoria fica circunscrita aos testes da própria Alibaba. Desenvolvedores interessados devem testar em seus casos de uso específicos antes de migração em produção.
Para quem trabalha com eventos globais, conferências multilingues ou traduções de conteúdo de vídeo em tempo real, a redução de latência e a diarização nativa podem justificar migração. A limitação técnica mais importante é o janela de contexto de 53.248 tokens, adequada para sessões típicas mas insuficiente para transcrições históricas muito longas. Observar a adoção real em ambientes de conferência será indicador mais confiável de valor do que as alegações de desempenho.
Fonte: MarkTechPost
Sobre o autor