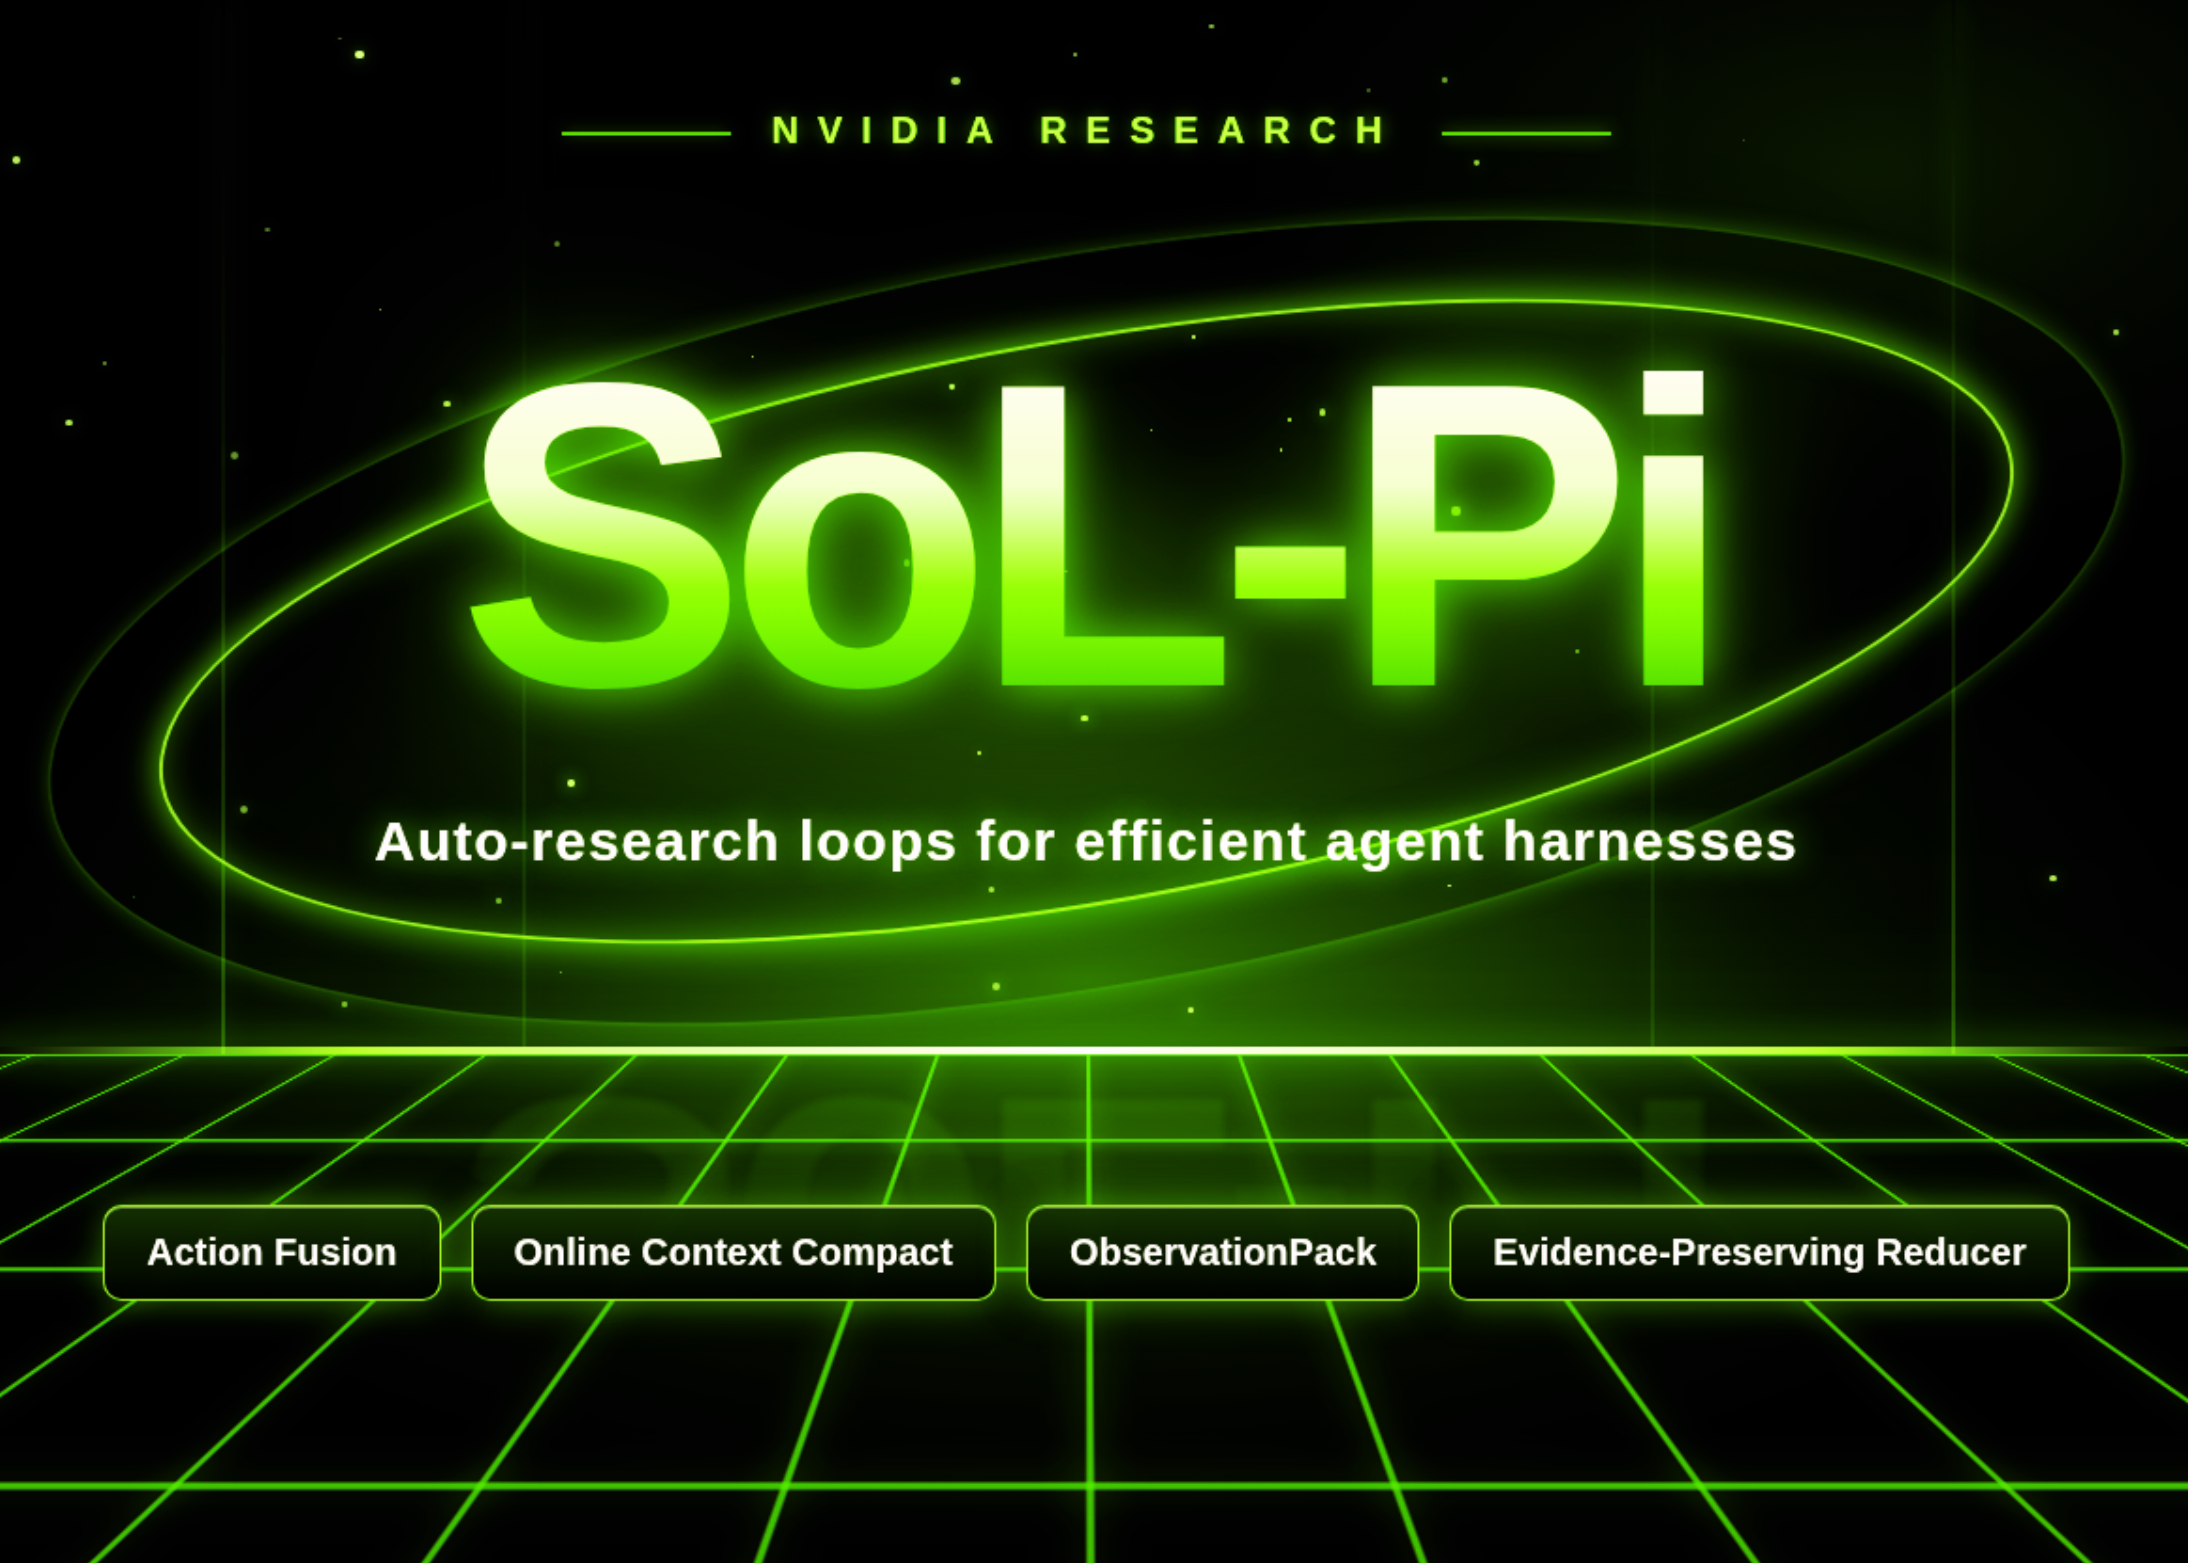
Pesquisadores da NVIDIA, em colaboração com universidades, lançaram SoL-Pi, um conjunto de 4 mecanismos de eficiência para o agente de código aberto Pi. A descoberta ocorreu através de loops de autopesquisa executados por uma inteligência artificial em 535 ambientes diferentes. O resultado: redução de 44,7% a 49,0% no tráfego de tokens e queda de aproximadamente 33% nos custos de API, enquanto mantém cerca de 94% da performance do Pi original em modelos como GPT-5.6 Sol e Opus 5.
O problema que SoL-Pi resolve
Agentes de código modernos enfrentam um desafio crescente: executam por horas, não minutos. Cada edição, execução de teste e leitura de log retorna ao contexto do modelo, multiplicando o consumo de tokens. Enquanto a maioria dos trabalhos de eficiência em IA busca reduzir o custo por token através de kernels mais rápidos, quantização ou modelos mais baratos, SoL-Pi segue outro caminho: reduz quantos tokens uma tarefa consome.
A camada onde essas operações ocorrem é chamada harness (arnês). Ela gerencia chamadas de ferramentas, contexto, observações e delegação. Ajustar um harness manualmente é lento, e suas partes são acopladas—uma correção em um lugar pode aumentar custos em etapas posteriores. Sistemas anteriores como Meta-Harness automatizavam esse trabalho, mas pesquisas recentes mostraram que harnesses evoluídos frequentemente se ajustam demais às tarefas de busca e entregam ganhos marginais em problemas novos.
Como SoL-Pi foi descoberto
Uma IA de pesquisa observou traces de execução de um agente Pi base em execução separada. Em seguida, propôs mudanças no harness e as testou. A busca cobriu:
- 152 direções propostas em 6 famílias: contexto, progresso, ferramentas, delegação, prompt e política
- 535 ambientes executáveis: 495 construídos a partir de pares issue-pull request do GitHub e 40 tarefas sintéticas com verificadores executáveis
- Mais de 3.000 execuções e 60.000+ interações agente-ambiente
Cada busca seguiu um ciclo de autopesquisa isolado, com um passo adicional de implementação e um revisor independente. As regras de aceitação foram fixadas antes da busca começar, e o otimizador não podia alterá-las. Toda métrica de capacidade tinha que permanecer dentro de uma tolerância predeclarada, e o candidato precisava melhorar pelo menos 1 métrica de eficiência. Crucialmente, o EdgeBench (conjunto de 51 tarefas públicas) foi mantido separado: 11 tarefas foram usadas para aceitação única de candidatos congelados, e 40 para avaliação final. Resultados do conjunto retido nunca alimentaram a busca.
Os 4 mecanismos explicados
O SoL-Pi combina quatro técnicas distintas para reduzir consumo de tokens:
Action Fusion: O Pi base frequentemente edita um arquivo e depois emite um comando separado para testá-lo, construí-lo ou executá-lo. O Action Fusion funde ambos em 1 requisição de ferramenta e retorna ambos os resultados em 1 observação, eliminando uma rodada de modelo.
Online Context Compact: Passos do plano são rastreados através de update_plan. Quando um passo é concluído, o harness estima quantas requisições permanecem e compara a economia de entrada projetada com o custo extra de reescrever o cache de prompt. Invoca a compactação nativa do Pi quando essa verificação passa ou quando o contexto se aproxima do limite da janela.
ObservationPack: Saídas de ferramentas acima de 10 KiB são arquivadas localmente e enviadas na íntegra para as próximas 2 requisições de provedor. A partir da 3ª requisição, o modelo vê um identificador estável, o tamanho original e um resumo das primeiras e últimas linhas. Páginas exatas permanecem recuperáveis através do identificador.
Evidence-Preserving Reducer: Logs de compilação e teste com pelo menos 4 KiB vão para um modelo mais barato, GPT-5.6 Luna em temperatura alta, que escreve um recibo compacto. Um verificador determinístico verifica o esquema do recibo, hash da fonte, status de saída, citações exatas e tamanho. O harness volta ao log original em 3 casos: verificação falha, credenciais suspeitas ou o recibo não é menor.
Resultados em ambientes diferentes
A pilha completa foi construída em GPT-5.6 Sol e movida para Opus 5 sem busca adicional. No Opus 5, mantém 94,3% da pontuação do Pi enquanto corta o tráfego de tokens em 44,7% e os custos de API em 33,5%. No GPT-5.6 Sol, mantém 93,7% da pontuação do Pi com 49,0% menos tokens e 33,2% de redução de custo.
Quando usados os melhores mecanismos isolados para cada backend—ObservationPack no GPT-5.6 Sol e Action Fusion no Opus 5—as pontuações aumentam 5,3% e 12,8% acima do Pi. No GPT-5.6 Sol, a pilha completa aumenta o tráfego de escrita de cache de 0,0141 B para 0,0316 B tokens, mas o custo total ainda cai, de $1.339 para $894.
| Cenário | Tarefas Resolvidas | Custo Total | Comparação com Pi |
|---|---|---|---|
| Terminal-Bench (63 tarefas CPU) | 15 (SoL-Pi) vs 18 (Pi) | $211,12 (SoL-Pi) | 26,3% redução vs Pi ($286,45) |
| IMO 2026, Lean 4-verificado | 3 de 6 (SoL-Pi e Pi) | $20,90 por problema | Menor custo por problema resolvido |
| Swarm de agentes (20 trabalhadores) | 1.127 ciclos (SoL-Pi) | $60,11 | vs 1.366 ciclos e $82,12 com Pi |
A equipe de pesquisa indica que a transferência entre modelos é preliminar. Os mecanismos acionam menos frequentemente no Opus 5, possivelmente porque a busca usou apenas trajetórias do GPT-5.6 Sol.
Disponibilidade e requisitos técnicos
SoL-Pi é implantável e está disponível no GitHub sob NVlabs como uma extensão licenciada por MIT que funciona com uma versão inalterada do Pi. Foi testado com Pi 0.85.1 e Node.js 22.19 ou mais recente. Trata-se de um plugin opcional que agentes e plataformas podem adotar sem modificar o Pi subjacente.
Implicações e limitações
Os resultados mostram que otimizações em nível de harness podem ser descobertas sistematicamente por autopesquisa. Porém, existem limitações: o desempenho em Opus 5 foi alcançado sem reotimização específica para esse modelo, sugerindo que ajustes posteriores poderiam melhorar ainda mais. Além disso, em tarefas de raciocínio matemático puro (IMO 2026) e ambientes CPU-only (Terminal-Bench), os ganhos de eficiência vieram com trade-offs em taxa de sucesso, reduzindo de 18 para 15 tarefas no Terminal-Bench.
O Evidence-Preserving Reducer, que delega compressão de logs para um modelo mais barato, introduz um ponto de falha potencial: se o verificador determinístico detectar um problema, o sistema recorre ao log original, anulando a economia. Isso significa que a confiabilidade da compressão é crítica para o resultado financeiro final.
Análise Panorama IA
SoL-Pi representa uma mudança conceitual no design de agentes: em vez de otimizar hardware ou modelos subjacentes, a pesquisa atacou a ineficiência estrutural do fluxo de informações dentro do agente. Isso importa porque agentes de código executam por horas, e reduções mesmo modestas em tokens por requisição se compõem em economias significativas—$4,36 a $13,50 por hora relatadas aqui.
Para produtores de plataformas e consumidores de APIs de modelos, SoL-Pi muda o cálculo de custo. Um desenvolvedor que executa agentes de código em produção pode agora considerar reduzir 33% em custos de API mantendo 94% da performance, uma troca aceitável para muitos cenários. O fato de ser uma extensão opt-in e não modificar o Pi base reduz fricção de adoção.
Porém, há limites importantes. A transferência entre modelos (Sol para Opus) funcionou sem reotimização, mas a performance em Opus é menor, sugerindo que eficiência e capacidade têm relações sensíveis ao modelo. Em tarefas de raciocínio puro, SoL-Pi sacrifica taxa de sucesso pela velocidade. Além disso, os mecanismos foram otimizados em um conjunto específico de problemas (GitHub issues e tarefas sintéticas); generalizabilidade para domínios completamente novos permanece em questão.
O que observar: como esses mecanismos interagem com agentes multi-modelo ou sistemas que delegam entre fornecedores diferentes (como coordenadores Codex observados no experimento de swarm), e se futuras otimizações do harness conseguem reduzir ainda mais o custo por token sem sacrificar capacidade em tarefas exigentes de raciocínio.
Fonte: MarkTechPost
Sobre o autor