
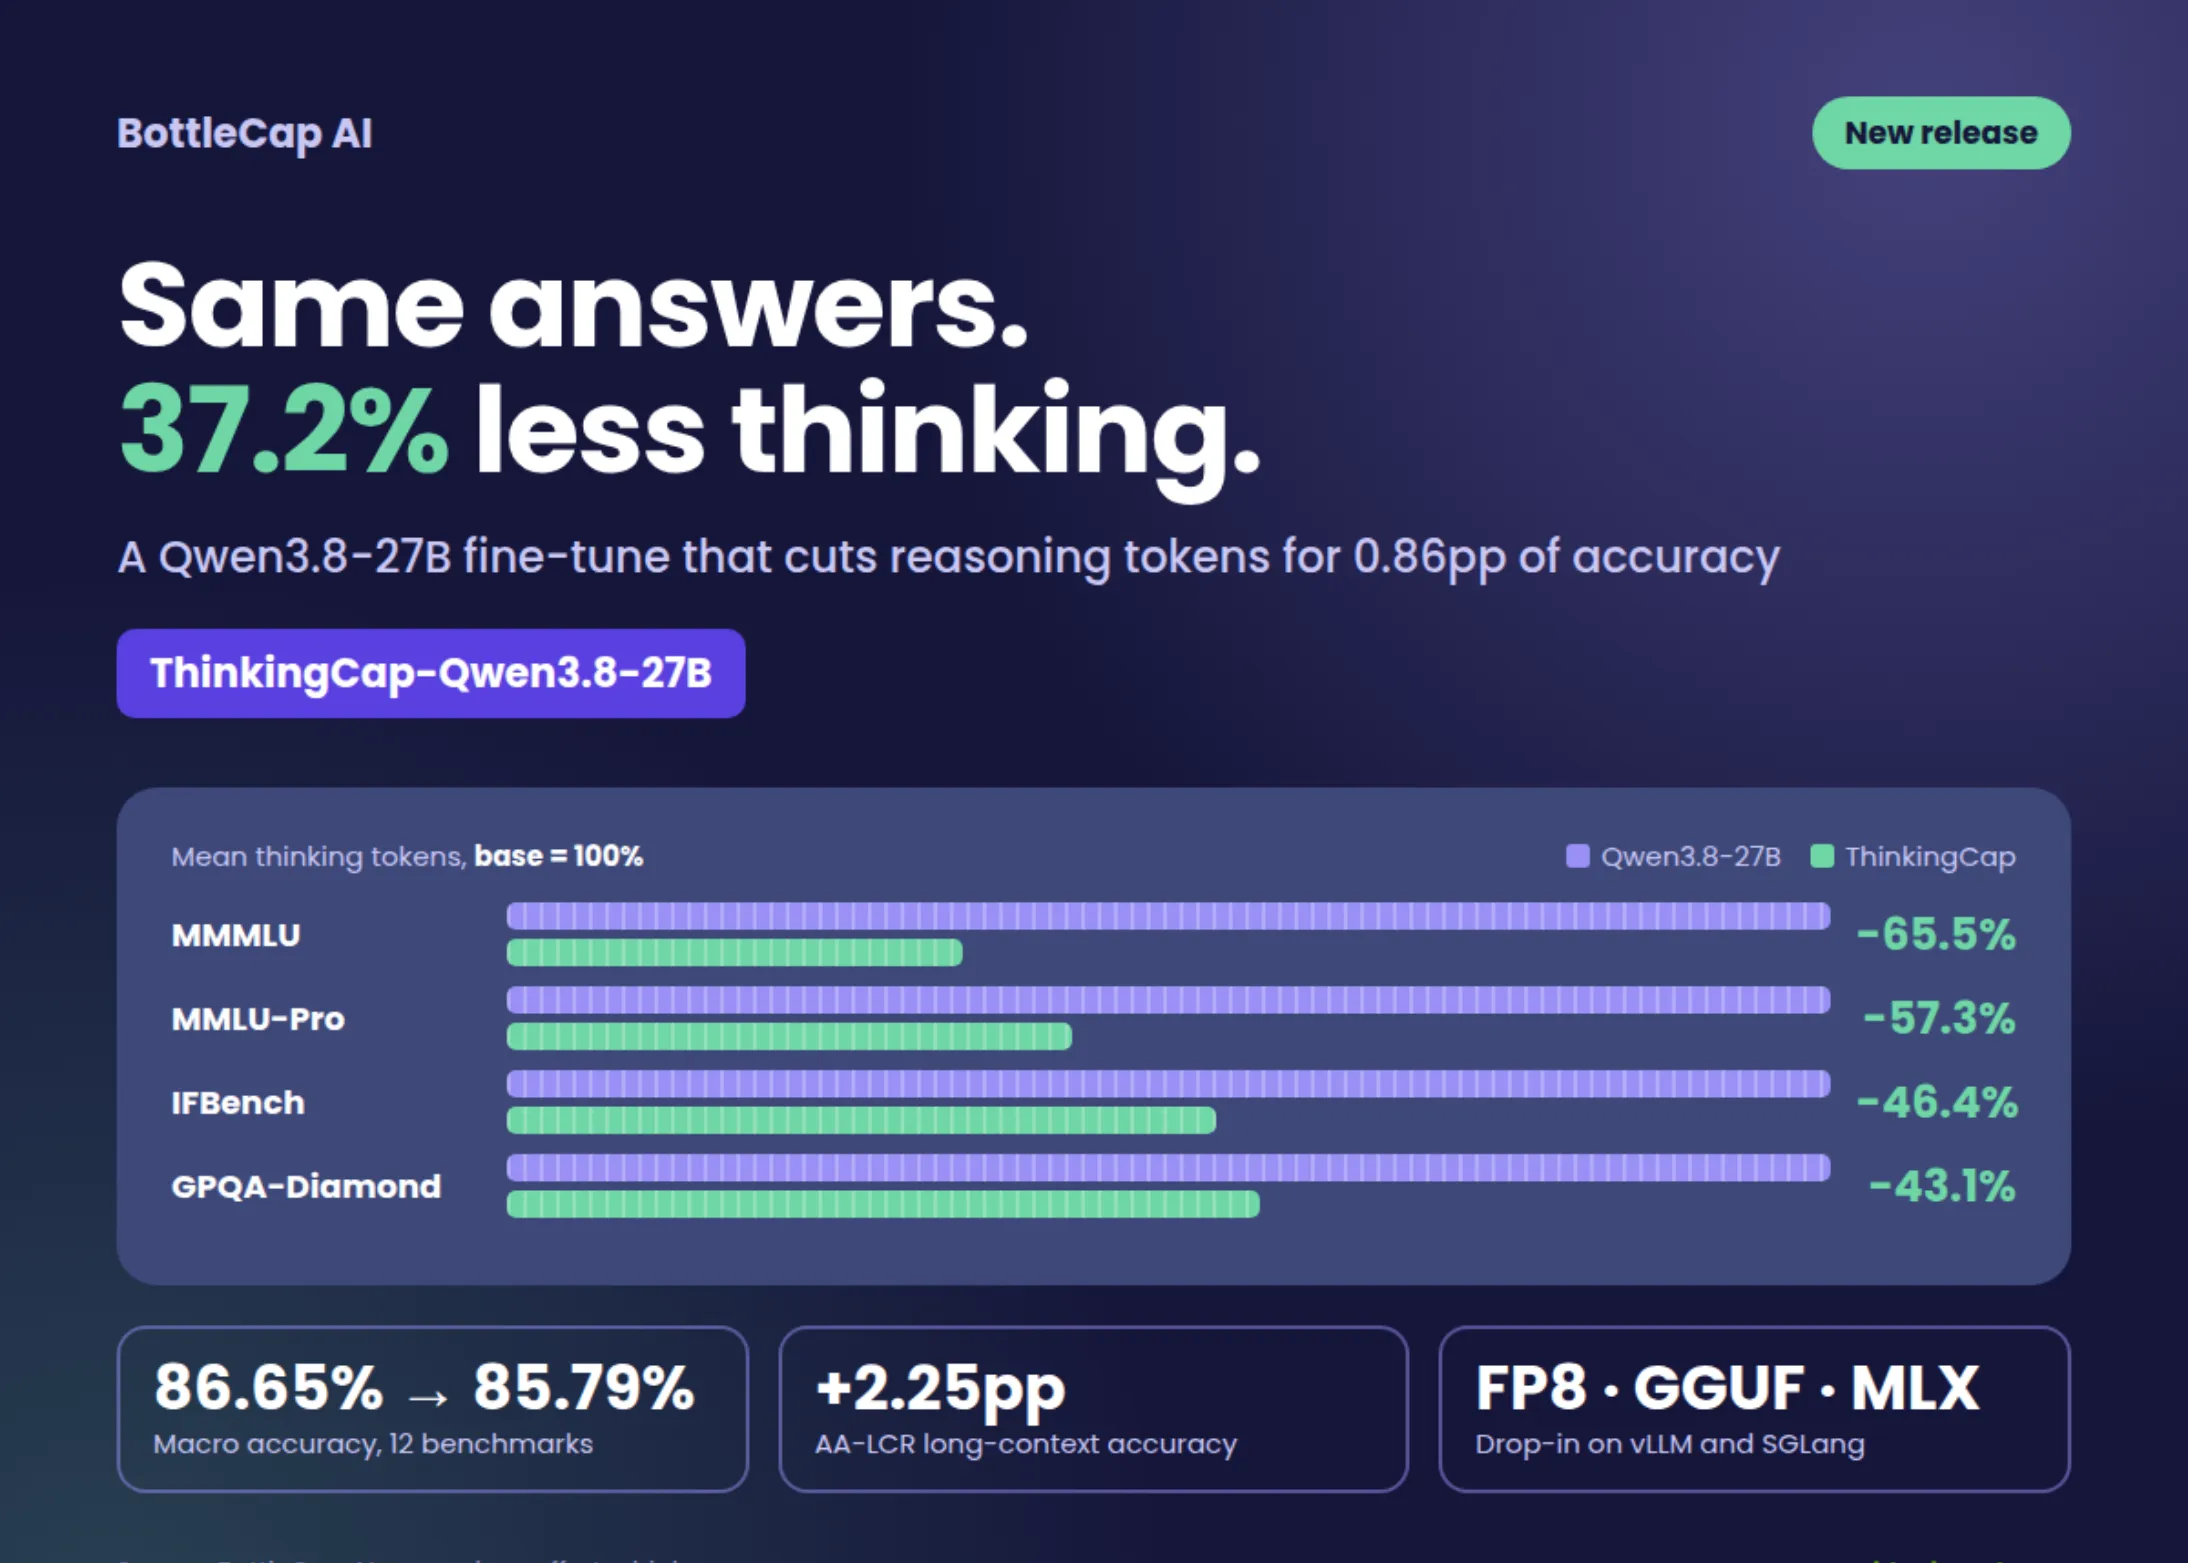
BottleCap AI lançou o ThinkingCap-Qwen3.8-27B, segundo modelo da série ThinkingCap. Trata-se de um ajuste fino do Qwen3.8-27B focado em reduzir traços de raciocínio desnecessários. Ao medir em 12 benchmarks diferentes, o modelo consome 37,2% menos tokens de raciocínio em média. O trade-off é uma queda de 0,86 ponto percentual na precisão geral, passando de 86,65% para 85,79%.
O que é a otimização de tokens de raciocínio
Modelos de raciocínio generativos, como o Qwen3.8-27B, utilizam “tokens de raciocínio” para processar passos intermediários antes de gerar uma resposta final. Esses tokens representam o pensamento interno do modelo e não aparecem na saída vista pelo usuário. A hipótese do BottleCap AI é que muitos desses tokens extras não alteram a resposta final, portanto podem ser removidos sem comprometer significativamente a qualidade.
O ThinkingCap-Qwen3.8-27B implementa essa ideia através de um ajuste fino conservador. A equipe de pesquisa não tentou adicionar conhecimento novo, alterar o estilo de resposta ou mudar o comportamento de segurança do modelo. A intenção foi deixar a capacidade de raciocínio, a compreensão de instruções e o comportamento seguro praticamente intactos.
Desempenho por benchmark
Os ganhos em eficiência não são uniformes entre diferentes tipos de tarefas. O modelo foi testado com reasoning_effort=xhigh, a configuração padrão do template de chat, e os resultados variam significativamente:
- Tarefas de conhecimento e multilíngues: apresentam as maiores reduções de tokens. MMMLU caiu 65,5% (de 1.656 para 571 tokens) e MMLU-Pro diminuiu 57,3%.
- Raciocínio matemático: GPQA-Diamond foi reduzido de 12.772 para 7.267 tokens, uma economia de 43,1%.
- Contexto longo: AA-LCR (Attribute-based Average Long-Context Retrieval) melhorou significativamente. A precisão subiu 2,25 pontos percentuais (de 81,75% para 84,00%) simultaneamente a uma redução de 38,6% em tokens de raciocínio—um resultado raro onde eficiência e qualidade aumentam juntas.
- Código ao vivo: LiveCodeBench v6 subiu 0,07pp enquanto economizava 20,3% em tokens de raciocínio.
- Trabalho agêntico: τ²-bench cedeu 1,01pp para ganhar 30,9% de redução. Terminal-Bench 2.1 perdeu 0,56pp—bem dentro de sua margem de ±4,26pp—para uma economia de 10,7%.
- Matemática avançada: AIME 2026 registrou o custo mais alto. A precisão caiu 3,85 pontos percentuais, de 98,13% para 94,27%, em troca de 30,2% menos raciocínio.
Compatibilidade e formatos disponíveis
O ThinkingCap-Qwen3.8-27B foi projetado como substituto direto do Qwen3.8-27B. Funciona nativamente em vLLM e SGLang com as mesmas flags e configurações de amostragem que o modelo base. BottleCap publica cinco variantes quantizadas para diferentes cenários de deployement:
- FP8: 31 GB, compatível com vLLM em GPUs Hopper e Blackwell.
- NVFP4 weight-only: 21 GB, rodável em vLLM com kernel Marlin em Hopper e Blackwell.
- NVFP4 W4A4 (AWQ): 23 GB, exclusivo para Blackwell.
- GGUF: 16 a 55 GB, para llama.cpp, LM Studio e Ollama.
- MLX 4-bit DWQ: 21 GB, otimizado para Macs com Apple Silicon e 32 GB de RAM.
O raciocínio interno retorna em um campo separado e independente da resposta. A configuração em vLLM e SGLang usa –reasoning-parser qwen3 com o parser qwen3_xml para chamadas de ferramentas. O modelo é baseado em um checkpoint bf16 de 28 bilhões de parâmetros que aceita entrada de texto e imagem.
Comportamento com limites de token
BottleCap também divulgou dados sobre o comportamento sob restrições de orçamento de token. Com um limite de 16.000 tokens por resposta, o ThinkingCap supera o modelo base. O índice de traços truncados caiu de 0,51% para 0,34%, e loops diminuíram de 0,06% para 0,05%. Isso sugere que a compressão de raciocínio é robusta mesmo sob pressão de limite de contexto.
A compressão também interage com os diferentes níveis de reasoning_effort que o Qwen3.8-27B expõe. Na configuração medium, o modelo base reduz 52,1% de tokens de raciocínio pela perda de 9,16pp; o ThinkingCap reduz 60,2% pela perda de 9,90pp. Na configuração low, o base cede 55,4% com queda de 9,71pp, enquanto o ThinkingCap reduz 62,3% com queda de 10,79pp. Com raciocínio desligado (reasoning=off), o ThinkingCap fica 5,7pp atrás do base.
Termos de uso e acesso
Os pesos do modelo estão sob guarda (gated) e licenciados sob PolyForm Small Business 1.0.0 com um complemento de uso pessoal do BottleCap. O uso comercial além da pequena empresa requer um acordo específico com BottleCap AI. Os materiais upstream do Qwen permanecem sob licença Apache-2.0. Até a data do lançamento, nenhum provedor de inferência hospedava o modelo publicamente.
Análise Panorama IA
O lançamento do ThinkingCap-Qwen3.8-27B aborda uma questão prática importante no deployment de modelos de raciocínio: a relação entre qualidade e custo operacional. Reduzir 37,2% dos tokens de raciocínio em média significa menor latência, menor uso de cache de contexto e, potencialmente, menor custo quando o provedor de inferência cobra por token processado. A perda de 0,86 pontos percentuais em precisão geral é negociável para muitas aplicações, especialmente considerando que alguns benchmarks como AA-LCR melhoram simultaneamente.
O padrão de redução entre tarefas revela algo importante: o modelo economiza mais agressivamente em categorias que requerem menos raciocínio profundo (conhecimento, multilíngue) e preserva mais raciocínio onde ele importa (AIME 2026, tarefas agênticas). Isso sugere que o ajuste fino aprendeu a diferenciar quando pensar é realmente necessário.
Para praticantes, a compatibilidade drop-in com vLLM e SGLang reduz fricção de adoção. A disponibilidade de múltiplos formatos quantizados (FP8, NVFP4, GGUF, MLX) democratiza acesso a diferentes arquiteturas de hardware. O ponto crítico é que BottleCap recomenda explicitamente reasoning_effort=xhigh para o melhor equilíbrio entre precisão e tokens—configurações mais baixas sofrem degradação adicional que pode não compensar a economia de tokens.
O contexto maior é que otimizações como esta surgem conforme modelos de raciocínio se normalizam. À medida que mais equipes deployarem agentes e sistemas com raciocínio explícito, a demanda por versões mais eficientes crescerá. O trabalho do BottleCap posiciona-se no cruzamento entre modelos agênticos de larga escala e ferramentas de otimização de custo operacional.
Fonte: MarkTechPost
Sobre o autor




