
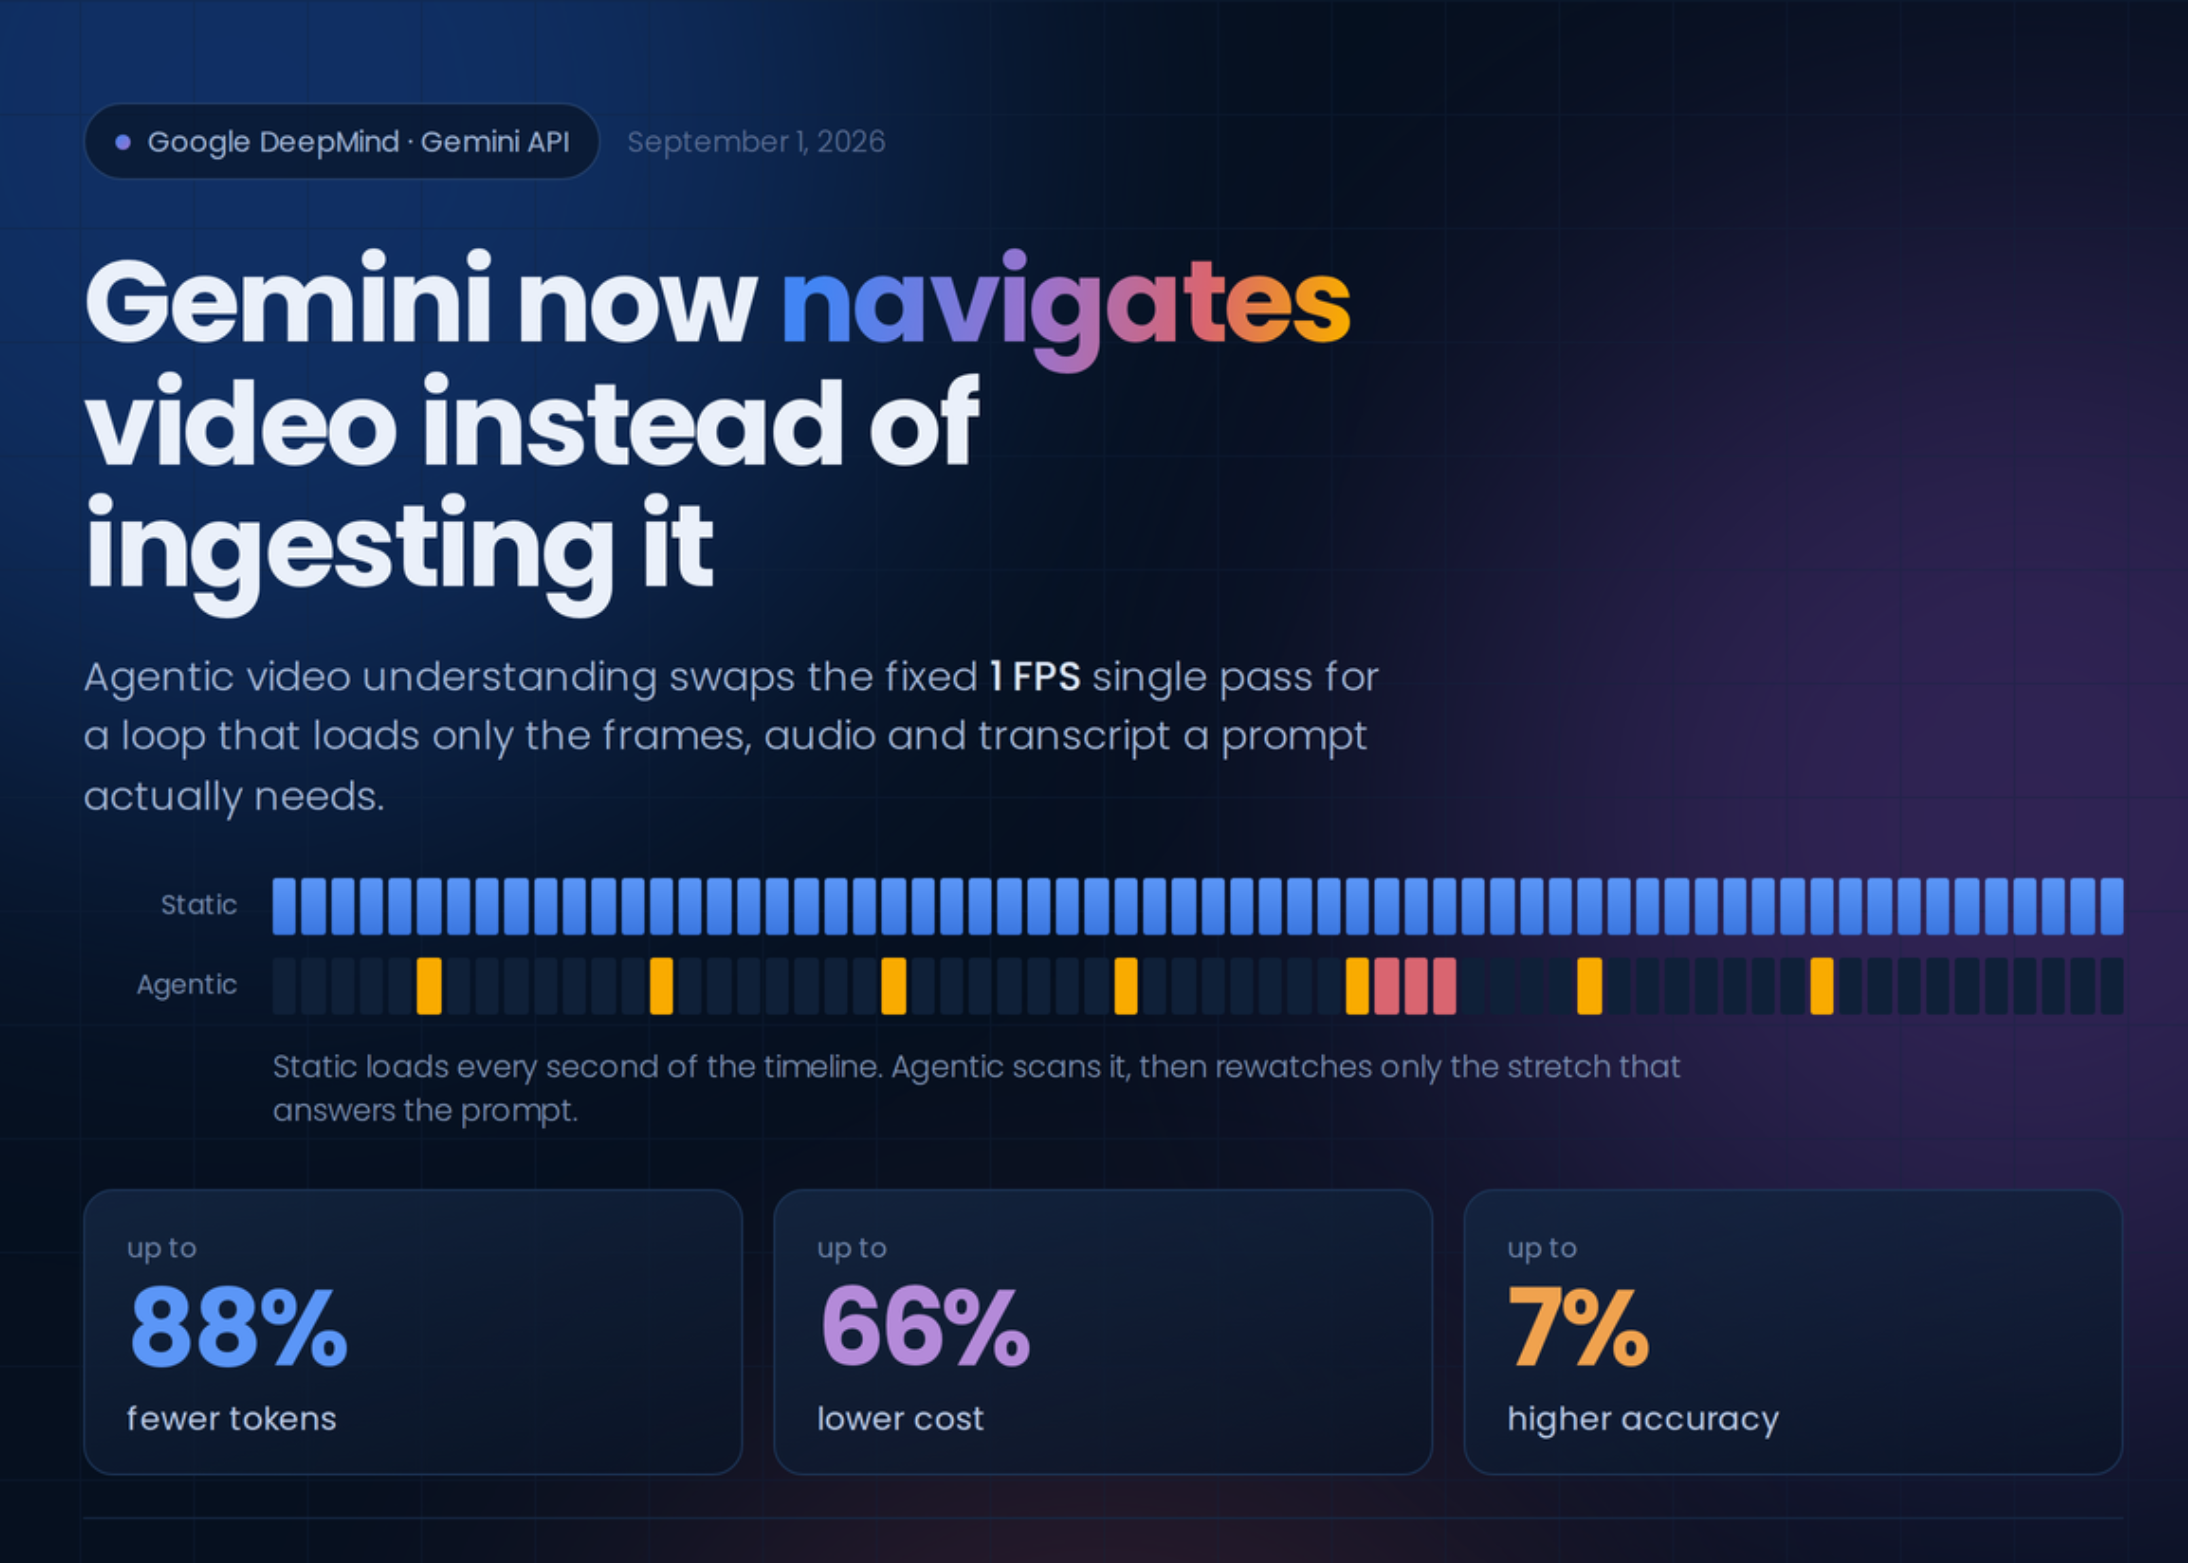
O Google passou a oferecer um modo agêntico de processamento de vídeo nos modelos Gemini Flash. Em vez de consumir o vídeo inteiro de forma uniforme, o modelo pode navegar pelo conteúdo e carregar apenas os trechos, quadros, áudio ou transcrições necessários para responder à solicitação.
Segundo a documentação do Gemini API, esse modo pode usar até 88% menos tokens em conteúdo longo, dependendo do vídeo e da pergunta. O ganho não é uma redução fixa garantida: tarefas que exigem inspeção de grande parte do material podem consumir mais.
Como o processamento tradicional funciona
No modo estático, o custo de tokens cresce de forma previsível com a duração do vídeo. A documentação do Google informa valores típicos próximos de 100 tokens por segundo em baixa resolução e 300 tokens por segundo em alta resolução, com amostragem de quadros ao longo do conteúdo.
Esse modelo é simples, mas pode ser ineficiente para perguntas pontuais. Se o usuário quer saber em que momento de uma palestra aparece um gráfico específico, por exemplo, não há necessidade lógica de analisar cada trecho com o mesmo nível de detalhe.
O que muda no modo agêntico
No processamento agêntico, o Gemini decide o que precisa consultar durante o raciocínio. Ele pode usar a transcrição para localizar uma região, abrir apenas determinados quadros, consultar o áudio ou ampliar a análise em um segmento específico.
| Modo | Como processa | Perfil de custo |
|---|---|---|
| Estático | Amostra o vídeo inteiro com regras predefinidas | Mais previsível e proporcional à duração |
| Agêntico | Navega e carrega apenas o que considera necessário | Variável; pode economizar muito em vídeos longos |
A documentação oficial usa como exemplo uma palestra de uma hora: uma análise estática poderia consumir cerca de 1,08 milhão de tokens, enquanto um processamento agêntico poderia ficar perto de 108 mil, dependendo da consulta e do conteúdo.
Onde a economia de 88% faz mais sentido
O benefício tende a ser maior quando o vídeo é longo e a pergunta exige localizar informação específica, como:
- encontrar o momento em que um tema é mencionado;
- identificar uma cena ou slide específico;
- responder perguntas sobre uma parte pequena de uma gravação extensa;
- consultar reuniões, aulas e entrevistas sem resumir tudo;
- extrair eventos pontuais de arquivos longos.
Quando a tarefa exige uma descrição completa de toda a sequência, contagem rigorosa de eventos ou observação contínua do movimento, a economia pode ser menor. A própria natureza agêntica significa que o consumo depende das decisões feitas pelo modelo.
O que isso muda para desenvolvedores
Para aplicações que processam horas de vídeo, tokens representam custo e latência. Reduzir a quantidade de conteúdo carregado pode viabilizar ferramentas que antes precisavam recortar vídeos manualmente ou construir sistemas próprios de busca temporal.
O ganho também muda a arquitetura. Em vez de preparar previamente todos os segmentos, o desenvolvedor pode delegar parte da navegação ao próprio modelo e acompanhar no retorno quais recursos foram usados durante o processamento.
Isso segue uma tendência semelhante à observada em sistemas de pesquisa automatizada: gastar computação seletivamente em vez de tratar todas as possibilidades com o mesmo custo. Nosso artigo sobre Research Preference Models da Meta FAIR mostra uma ideia relacionada aplicada à escolha de experimentos de IA.
Limitações e cuidados
“Até 88%” deve ser interpretado como um resultado possível em determinados cenários, não como promessa para qualquer vídeo. O consumo real depende de duração, resolução, complexidade visual, presença de áudio e transcrição, além da pergunta feita.
Também é importante verificar a versão do modelo e a documentação atual da API antes de implementar. O Google atualiza rapidamente a família Gemini Flash e recursos podem mudar de disponibilidade, nome ou comportamento.
Análise Panorama IA
O avanço mais relevante aqui não é simplesmente “usar menos tokens”. É transformar vídeo em um espaço que o modelo pode explorar sob demanda. Isso aproxima a análise multimodal do comportamento de uma pessoa que folheia uma gravação em busca da parte relevante, em vez de assistir ao material inteiro para responder a uma pergunta pontual.
Para produtos de IA, essa mudança pode ser tão importante quanto aumentar a qualidade do modelo, porque reduz custo por tarefa. Também fortalece uma das vantagens do ecossistema Gemini em multimodalidade, tema que detalhamos em nossa comparação Gemini vs Claude.
Fontes: documentação oficial do Gemini API sobre tokens e MarkTechPost.
Sobre o autor




