
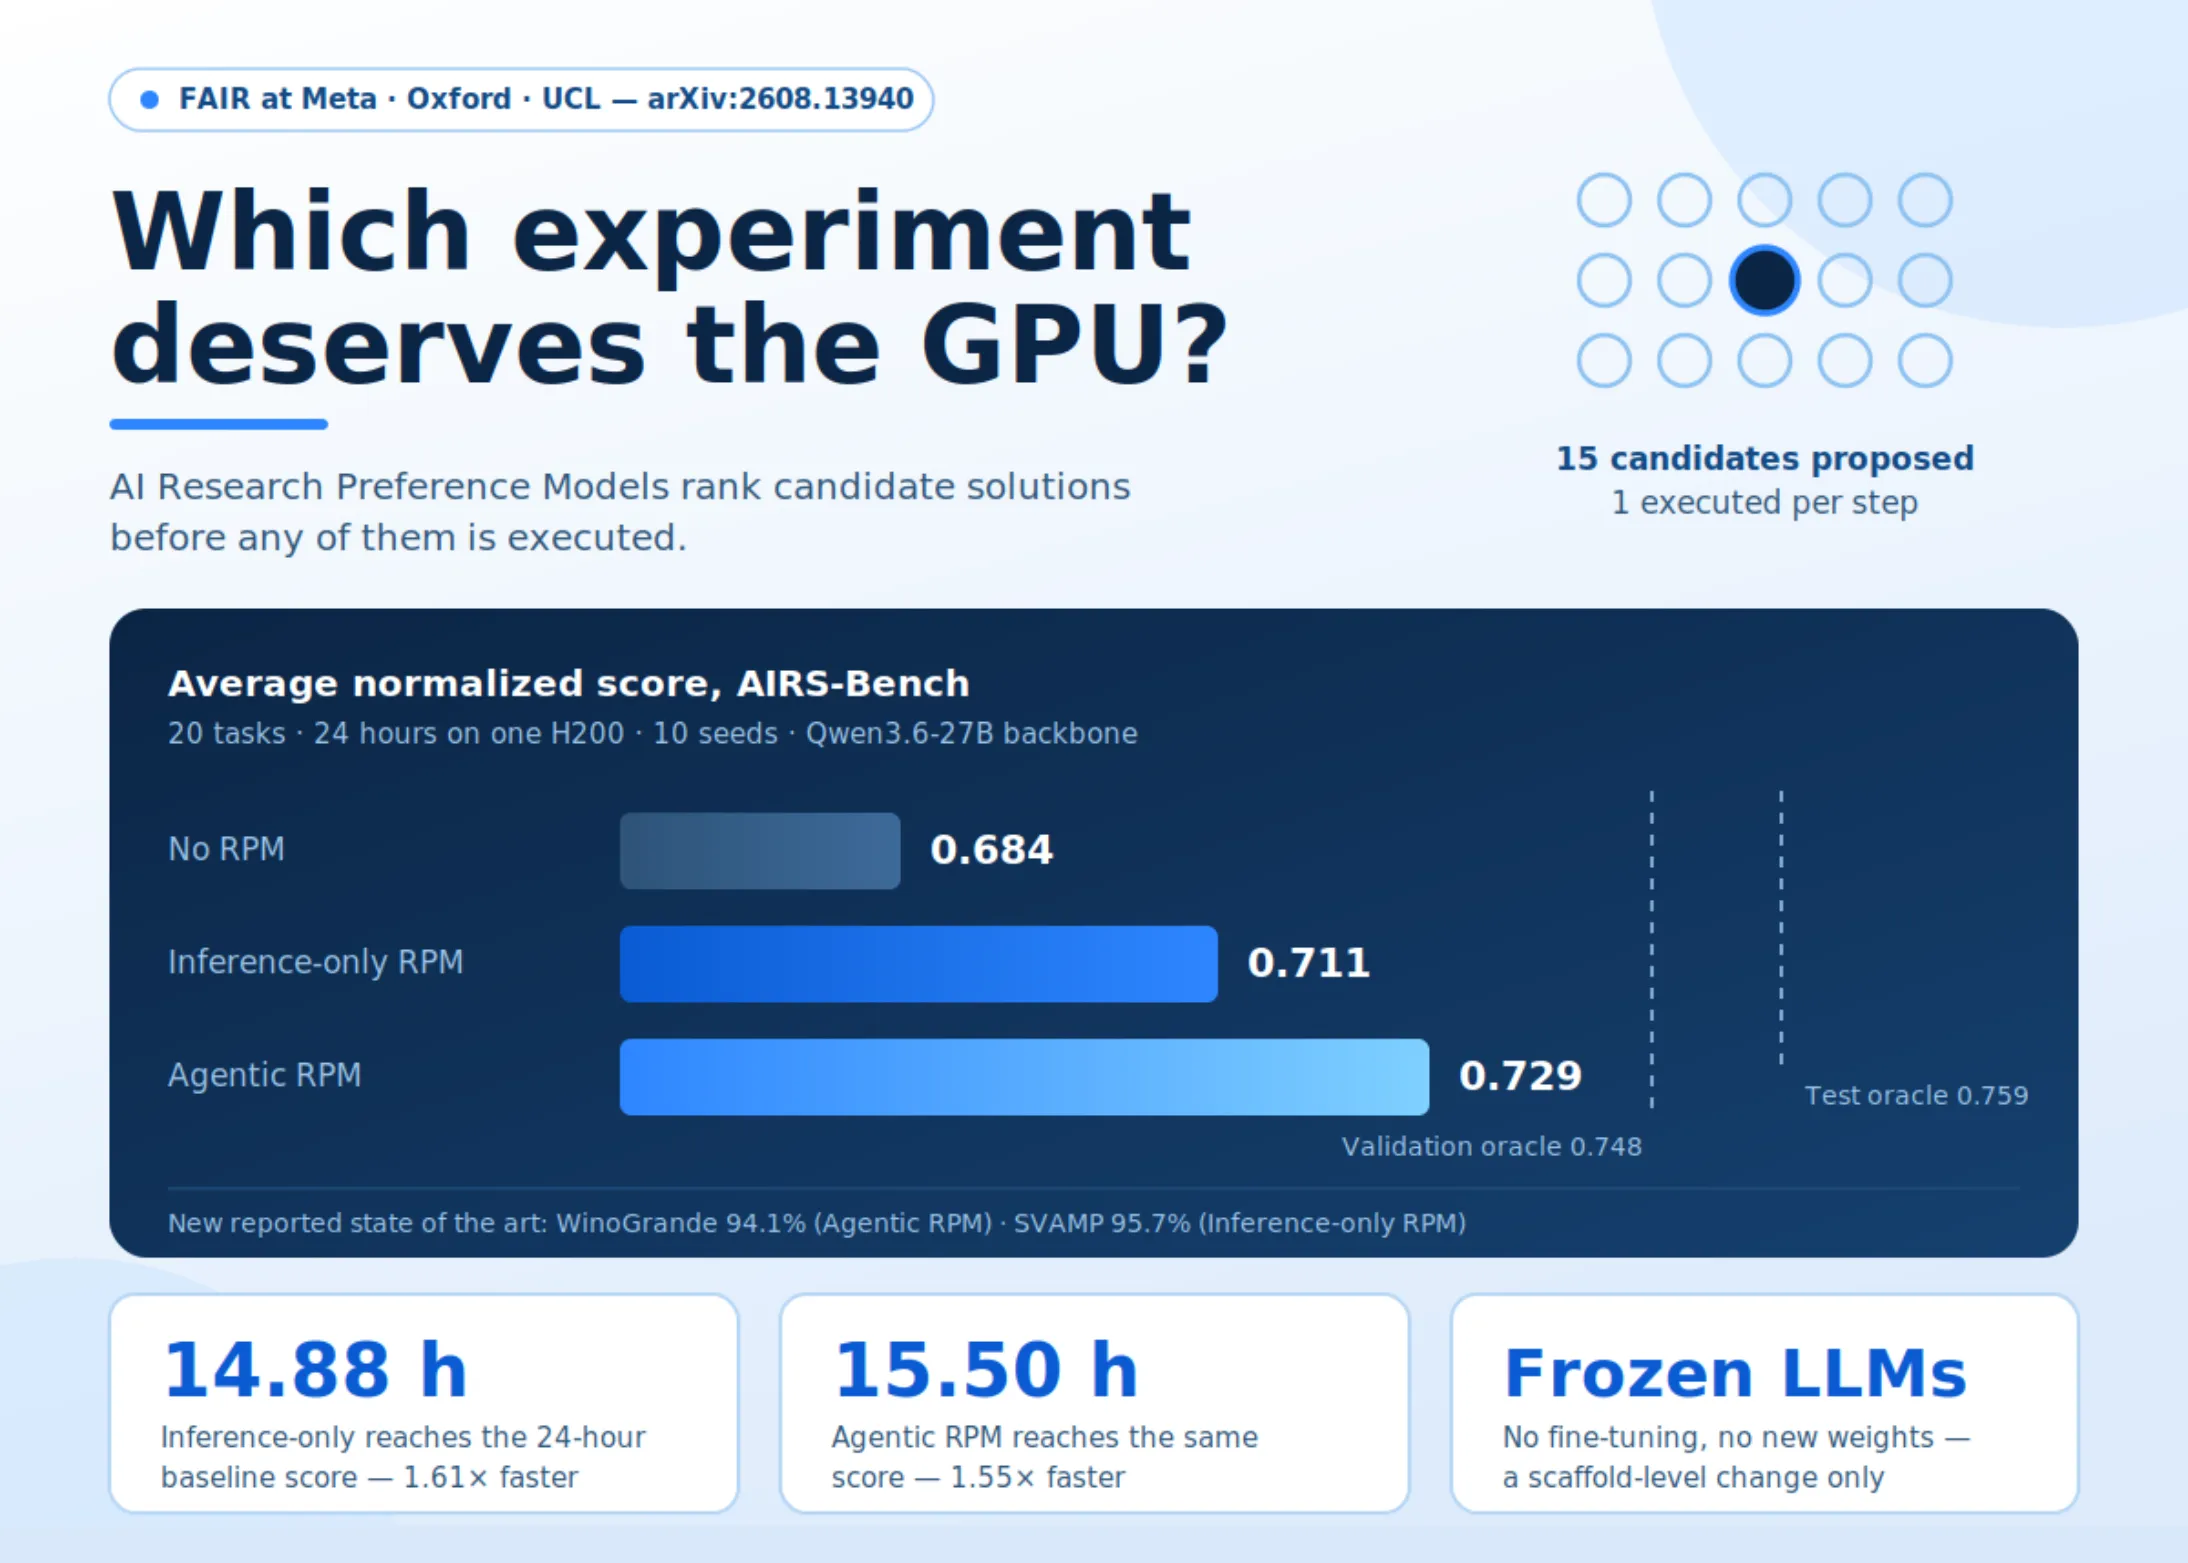
Pesquisadores da Meta FAIR, da Universidade de Oxford e da University College London (UCL) propuseram os AI Research Preference Models (RPMs), uma técnica para decidir quais experimentos de aprendizado de máquina merecem consumir tempo de GPU antes que todos sejam executados. O trabalho ataca um gargalo cada vez mais relevante em pesquisa automatizada: agentes de IA conseguem propor muitas hipóteses rapidamente, mas testar cada uma delas continua caro e demorado.
Em vez de tentar prever a pontuação final de um experimento, os RPMs comparam candidatos e escolhem quais parecem mais promissores dentro de um orçamento limitado de computação. A proposta foi descrita no artigo científico AI Research Preference Models.
O que os RPMs fazem na prática
O sistema funciona como uma camada de priorização. Um agente de pesquisa gera várias soluções candidatas; o RPM analisa planos, código e resultados anteriores e então seleciona qual candidato será executado. O objetivo não é substituir o experimento real, mas gastar o orçamento de GPU onde há maior chance de retorno.
Os pesquisadores testaram duas variantes:
- RPM somente por inferência: avalia os candidatos usando um modelo de linguagem já treinado, sem executar testes adicionais.
- RPM agêntico: além da análise, pode executar pequenos experimentos-piloto antes de escolher o candidato principal.
Em ambos os casos, os modelos usados como avaliadores permanecem congelados, sem treinamento específico para a tarefa. Isso é importante porque permite separar o ganho obtido pela estratégia de seleção do ganho que poderia vir simplesmente de utilizar um modelo mais forte.
Resultados no AIRS-Bench
O estudo avaliou os RPMs no AIRS-Bench, benchmark voltado a agentes de pesquisa em aprendizado de máquina. Segundo o artigo, a pontuação normalizada média subiu de 0,684, na seleção aleatória, para 0,711 com o RPM somente por inferência e 0,729 com o RPM agêntico.
| Método | Pontuação média normalizada |
|---|---|
| Seleção aleatória, sem RPM | 0,684 |
| RPM somente por inferência | 0,711 |
| RPM agêntico | 0,729 |
Outro resultado relevante foi o tempo necessário para atingir o desempenho que o agente sem RPM alcançava após 24 horas. As variantes com RPM chegaram a esse nível em aproximadamente 15 horas, usando menos de dois terços do orçamento de execução. Isso não significa que todo projeto de IA terá a mesma economia: os números pertencem ao ambiente experimental do estudo e dependem do benchmark, do hardware e da qualidade dos candidatos gerados.
Por que isso importa para equipes de IA
O ponto mais interessante não é apenas a redução de horas de GPU. A técnica muda a pergunta operacional de “quantos experimentos conseguimos executar?” para “quais experimentos merecem ser executados?”. Em laboratórios, startups e equipes acadêmicas, essa diferença pode determinar quantas hipóteses são exploradas dentro de um orçamento fixo.
Para organizações que já usam agentes para pesquisa, engenharia ou otimização, há uma lição mais ampla: aumentar a autonomia sem uma boa política de seleção pode apenas acelerar o desperdício. Esse mesmo problema aparece em projetos empresariais de agentes de IA, nos quais custo e valor de negócio precisam ser avaliados antes da automação. Veja também nossa análise sobre a previsão da Gartner para projetos de IA agêntica.
Limitações que precisam ser consideradas
Os resultados são promissores, mas não demonstram que um LLM consegue saber de forma geral qual pesquisa científica vai funcionar. O estudo avalia um conjunto específico de tarefas de aprendizado de máquina, com regras e orçamento definidos. Em áreas onde uma pequena mudança metodológica altera completamente o resultado, a preferência do modelo ainda pode escolher mal.
Também existe um custo no próprio processo de seleção. No RPM agêntico, os testes-piloto consomem parte do orçamento que seria usado nos experimentos principais. Portanto, o benefício depende de os pilotos serem suficientemente baratos e informativos para compensar esse gasto adicional.
Análise Panorama IA
Os RPMs apontam para uma mudança importante na automação científica: o gargalo deixa de ser apenas gerar ideias e passa a ser administrar atenção computacional. À medida que agentes produzem dezenas ou centenas de candidatos, sistemas de triagem tornam-se parte central da arquitetura.
Isso aproxima a pesquisa automatizada de um processo humano bem administrado: primeiro se formula várias hipóteses, depois se executam testes baratos para eliminar opções fracas e, só então, se investe pesado nas melhores. A diferença é que esse ciclo pode ser realizado em velocidade de máquina. Para entender como laboratórios estão tentando acelerar esse processo de descoberta, leia também nossa cobertura sobre aceleração de pesquisa em IA.
Fontes: artigo científico no arXiv e MarkTechPost.
Sobre o autor




