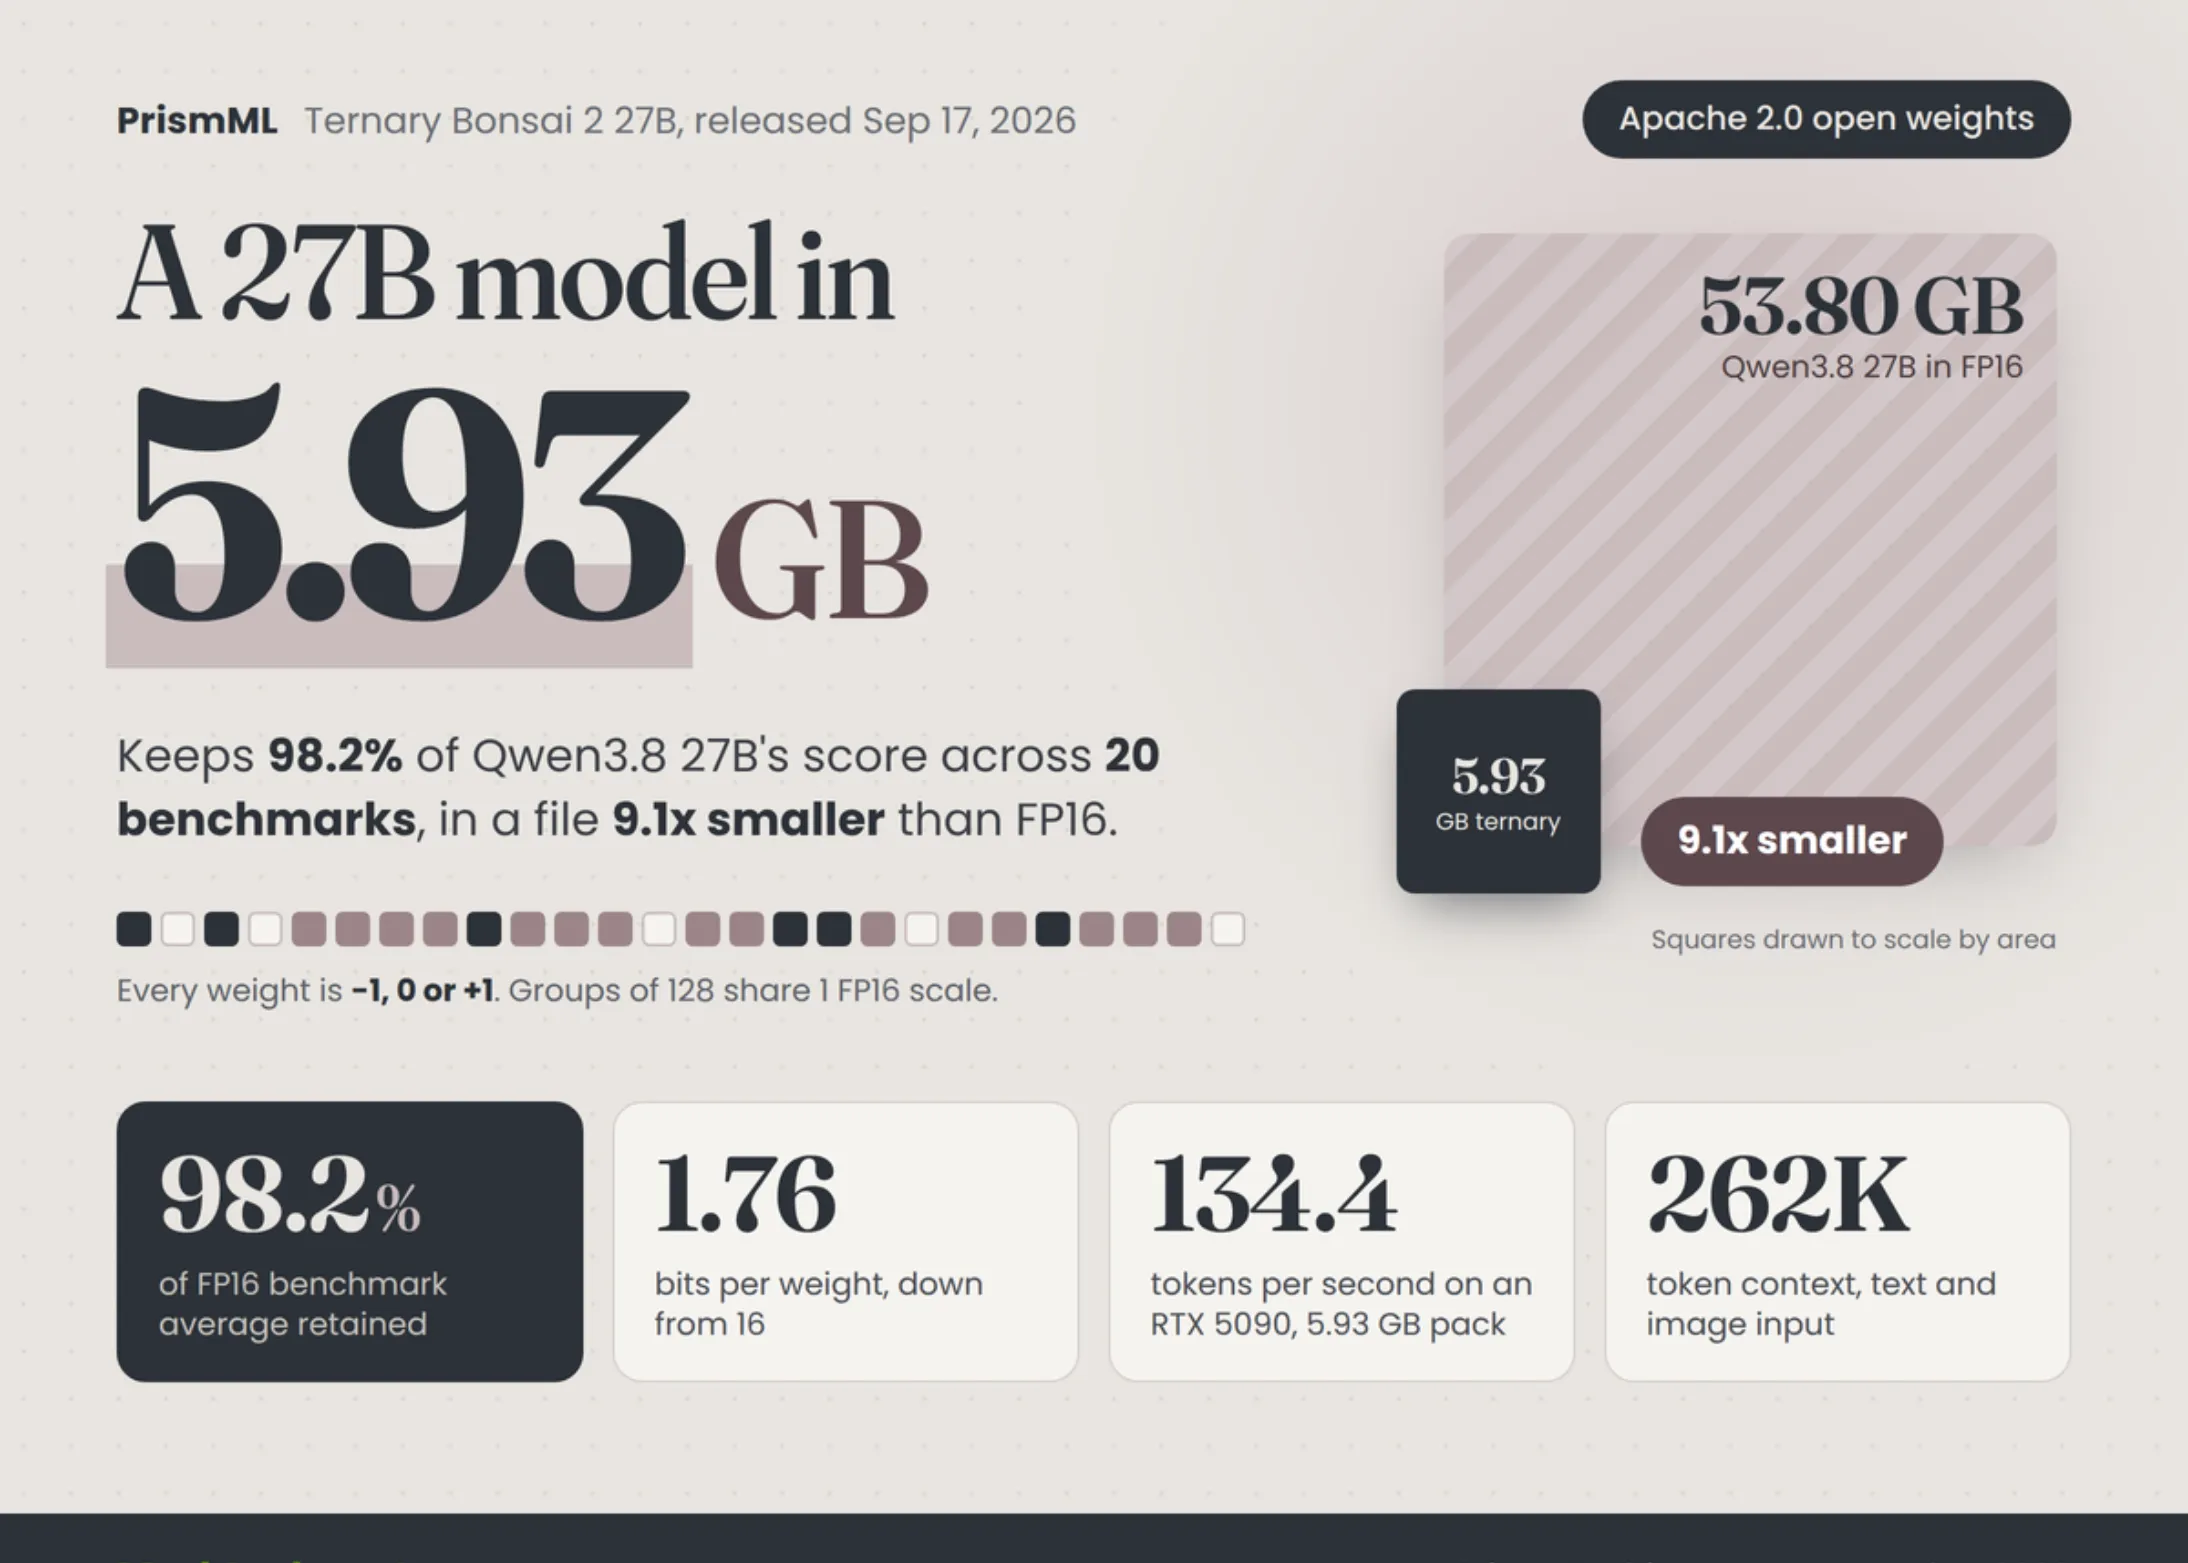
PrismML divulgou o Ternary Bonsai 2 27B, uma versão com pesos ternários do modelo Qwen3.8 27B. O modelo comprimido ocupa 5,93 GB contra 53,80 GB da versão em precisão total (FP16), representando uma redução de aproximadamente 9 vezes no tamanho. De acordo com a empresa, o modelo retém 98,2% do desempenho médio do modelo original quando avaliado em 20 benchmarks de referência. A implementação suporta entrada de texto e imagens, com suporte a contexto de 262 mil tokens.
Arquitetura e Técnica de Compressão
O Ternary Bonsai 2 27B preserva a arquitetura original do Qwen3.8 27B, mantendo seus 27,36 bilhões de parâmetros, mas aplicando quantização ternária seletiva. A estrutura se divide em um núcleo de linguagem com 24,35 bilhões de parâmetros, 2,54 bilhões em embeddings e head de linguagem, e uma torre de visão com 0,47 bilhões de parâmetros.
A compressão funciona transformando os pesos em um de três valores: -1, 0 ou +1. Grupos de 128 pesos compartilham uma única escala em FP16. Como cada valor ternário requer aproximadamente 1,585 bits (log₂3), combinado com a escala, o resultado final é de 1,72 bits por peso. Apenas 26,2 milhões de parâmetros (0,0976% do total) mantêm precisão mais alta, especificamente o caminho de estado recorrente e pesos de normalização.
PrismML implementa uma rotação de Hadamard em blocos de tamanho 1.024 antes da atribuição dos valores ternários. Essa transformação é aplicada novamente nas ativações em tempo de execução antes de cada multiplicação. A técnica é baseada no método SpinQuant descrito na literatura de quantização.
Desempenho e Perdas Assimétricas
Embora o modelo retenha 98,2% de desempenho em média, as perdas não são uniformes entre diferentes categorias de tarefas:
- Visão: retenção de 96,3%
- Conhecimento e raciocínio: retenção de 96,9%
- Trabalho com agentes de longo horizonte: retenção de aproximadamente 75% (Terminal-Bench 2.1 obtém 52,8 contra 69,7 do modelo original; SWE-bench Verified obtém 60,8 contra 80,6)
Em tarefas específicas, as diferenças são mais acentuadas. No benchmark AIME26, o Bonsai 2 obtém 95,83 pontos enquanto a versão IQ2_XXS do Qwen3.8 27B (outro modelo comprimido) consegue 78,6. No LiveCodeBench v6, o Bonsai 2 alcança 90,07 contra 70,05 da versão IQ2_XXS. Em esforço de raciocínio médio, o modelo reduzido atinge média de 79,3 contra 82,6 do baseline em FP16. O modo de esforço baixo não é suportado.
Disponibilidade e Requisitos de Hardware
O modelo é imediatamente executável em laptops com 16 GB de RAM ou em uma única GPU com 24 GB de memória. A implementação requer a utilização de um fork personalizado do llama.cpp mantido por PrismML, ou seu runtime MLX. O llama.cpp padrão não consegue carregar os tipos de quantização PTQ1_0 e PQ2_0 utilizados no modelo.
Os arquivos em formato GGUF são oferecidos em duas variações com diferentes compromissos de velocidade e tamanho:
- PTQ1_0: empacota os valores densamente a 1,76 bits por peso, resultando em 5,93 GB, mais rápido em GPUs da geração Ada e GPU L4
- PQ2_0: armazena cada valor em um slot de 2 bits a 7,25 GB, mais barato de desempacotar, mais rápido em Blackwell, Hopper, Ampere e silício Apple, assim como no processamento de prompts
A torre de visão é fornecida como arquivo separado de 0,63 GB e carregada apenas quando há entrada de imagem.
Velocidade de Inferência
Os benchmarks de velocidade foram medidos em 16 de setembro de 2026 em modo decodificação com tamanho de batch 1 usando kernels personalizados de PrismML. Os resultados variam conforme o hardware:
- RTX 5090: 142,5 tokens por segundo (0,582 mWh por token)
- RTX 4090: 96,7 tokens por segundo com PTQ1_0
- GPU L4 de 72 W: 32,1 tokens por segundo
- Apple M5 Max: 46,8 tokens por segundo
- Apple M5 Pro: 27,7 tokens por segundo
PrismML também afirma 40% melhor eficiência energética em comparação com um modelo de precisão total com 8 bilhões de parâmetros, embora este dado não tenha sido independentemente verificado.
Contexto Histórico
O Ternary Bonsai 2 27B foi lançado dois meses após a primeira versão do Bonsai 27B, cuja variante ternária retinha aproximadamente 95% do desempenho. A evolução demonstra refinamento tanto na técnica de quantização quanto no desempenho obtido na compressão.
Limitações e Ressalvas
Todos os resultados apresentados são próprios de PrismML e não foram reproduzidos independentemente por terceiros. A perda de desempenho em tarefas de agentes de longo horizonte é significativa (aproximadamente 25%), indicando que o modelo pode não ser ideal para cenários que exigem planejamento estendido ou execução de tarefas complexas em múltiplas etapas. PrismML não divulga publicamente como os valores ternários são atribuídos aos pesos, limitando a possibilidade de replicação ou auditoria da técnica.
Análise Panorama IA
O lançamento do Ternary Bonsai 2 27B representa um avanço relevante em quantização seletiva de modelos de linguagem multimodais. A retenção de 98,2% de desempenho em 20 benchmarks enquanto reduz o tamanho em aproximadamente 9 vezes abre possibilidades de implantação em ambientes com recursos limitados, como laptops pessoais e dispositivos edge.
A importância prática reside na democratização do acesso a modelos capazes. Um profissional ou desenvolvedor agora pode executar um modelo de 27 bilhões de parâmetros em hardware commodity, sem necessidade de infraestrutura em nuvem. A compatibilidade com agentes de código (demonstrada com Cline) e processamento de imagens expande os casos de uso possíveis em contextos locais.
Contudo, a perda assimétrica de desempenho em tarefas de agentes com horizonte estendido (redução para 75%) estabelece uma fronteira clara: o modelo é adequado para assistência textual, raciocínio moderado e processamento de visão, mas não para automação complexa que exija múltiplas etapas de planejamento sem supervisão. Além disso, a dependência de um fork do llama.cpp e a falta de transparência sobre o método de atribuição de pesos ternários criam barreiras à auditoria e adoção em contextos que exigem rastreabilidade.
O que observar adiante: a reprodução independente dos benchmarks, a evolução da técnica em outras famílias de modelos e a eventual integração das otimizações em runtimes padrão determinarão se essa abordagem se torna um padrão de compressão viável ou permanece como nicho especializado dentro do ecosistema de modelos locais.
Fonte: MarkTechPost
Sobre o autor