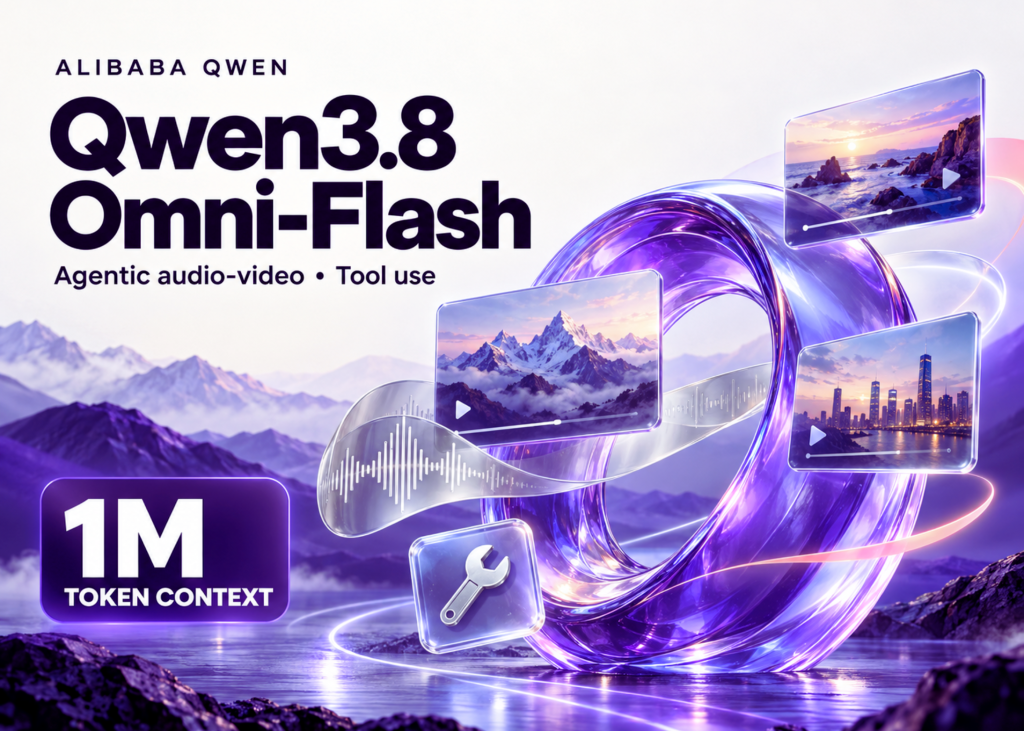
A Alibaba anunciou o lançamento do Qwen3.8-Omni-Flash, seu primeiro modelo multimodal construído em torno de capacidades agênticas. O modelo aceita texto, imagens, áudio e vídeo como entrada e retorna apenas texto. A proposta diferencia-se pela integração de compreensão de áudio-vídeo, raciocínio e uso de ferramentas em uma única arquitetura voltada para agentes de IA.
Arquitetura e disponibilidade
O Qwen3.8-Omni-Flash é construído sobre a arquitetura Qwen3.8-Flash-Next, cujo modelo base foi lançado com pesos abertos em agosto de 2026. Porém, o modelo multimodal permanece disponível apenas via API hospedada, sem pesos abertos anunciados no lançamento. Está disponível em QwenCloud, Alibaba Cloud Model Studio e Qwen Studio.
O contexto do modelo atinge 1M de tokens, com máximo de entrada de 991K tokens e saída de 131K tokens conforme listado no QwenCloud. O comprimento máximo de raciocínio é de 262K tokens. A saída é somente texto, e o raciocínio (“thinking”) vem ativado por padrão com nível de esforço máximo.
A API suporta tanto os protocolos DashScope quanto OpenAI, funcionando com Chat Completions e a API Responses. Oferece suporte a chamadas de função, busca na web, saídas estruturadas, cache de contexto e chamadas em lote.
Estratégia agêntica para processamento de mídia
A abordagem diferencial do Qwen3.8-Omni-Flash está na forma como processa vídeos. Enquanto modelos tradicionais leem arquivos sequencialmente do início ao fim independentemente de onde a resposta se encontra, este modelo adota uma estratégia agêntica: começa pela questão, decide o que assistir e ouvir, e reúne evidências em múltiplas rodadas de refinamento progressivo. Isso concentra poder de processamento nos segmentos relevantes.
Segundo relatos do time de pesquisa de Qwen, essa abordagem produziu resultados medidos no OmniVideoBench: a precisão subiu de 63,4% para 67,8%, enquanto o uso de tokens caiu de 145.736 para 79.117, representando redução de aproximadamente 45,7% no consumo de tokens. É importante notar que estes números provêm de dados da Alibaba e resultados independentes não estavam disponíveis no momento da publicação.
Desempenho em múltiplos benchmarks
Em avaliação abrangente de 29 testes, o Qwen3.8-Omni-Flash apresenta melhoria superior a 25% na pontuação média em relação ao Qwen3.5-Omni-Plus. O desempenho varia significativamente conforme o benchmark:
- WildClawBench-MM: melhoria de 36,5 pontos
- AgenticVBench: melhoria de 22,3 pontos
- UniClawBench: atinge 69,6
- LongAudioSpan: ganho de 8,3 pontos
- OmniVideoBench: ganho de 9,6 pontos
- OmniCap-IF: melhorias de 8,5 e 14,1 pontos (CSR e ISR respectivamente)
O time de pesquisa afirma que o desempenho em áudio-visual fica próximo ao do Gemini 3.8 Flash, enquanto alega superioridade em desempenho geral de áudio. Em ganhos agênticos especificamente, relata melhoria média de +19,5 pontos em WildClawBench-MM e UniClawBench combinados.
Custos e limitações técnicas
O QwenCloud lista preço de $0,15 por 1M tokens de entrada e $0,47 por 1M tokens de saída. Cache implícito custa $0,016 por 1M tokens. A equipe de pesquisa relata reduções significativas de custo em comparação com Qwen3.5-Omni-Plus: custo de áudio reduzido em mais de 98% por hora, áudio-visual em mais de 93% por hora, e vídeo em aproximadamente 89%.
As limitações técnicas documentadas incluem:
- Vídeos limitados a 2 horas e 2 GB por URL
- Áudio limitado a 3 horas
- Entrada de áudio disponível em 113 idiomas e dialetos
- Resultados estáveis com vídeo amostrado até 15 fps
- Suporte a áudio estéreo de dois canais e áudio espacial FOA de quatro canais
- Disponibilidade em 6 regiões: Beijing, Singapura, Hong Kong, Tóquio, Frankfurt e Virginia
Ecossistema de plugins e integração com agentes
Como o modelo retorna apenas texto, ferramentas externas realizam o processamento de mídia. A Alibaba está disponibilizando em código aberto dois projetos de suporte: Qwen-MM-Plugins sob licença Apache-2.0 com o slogan “Make any agent harness multimodal-native”. Cada capacidade instala-se como uma Skill com servidor MCP opcional.
O instalador guiado suporta Claude Code, CodeBuddy, Codex, Qoder, OpenClaw, Qwen Code e Gemini CLI. Os plugins mapeiam três demonstrações principais: omni-memory para construir memória áudio-visual de vídeos longos, omni-video2note para converter vídeos tutoriais em PDFs ilustrados, e omni-chatcut para Música-para-MV, comentários de filmes e tradução de vídeo preservando locutores.
Um plugin essencial permite que o modelo principal leia imagens e quadros de vídeo locais nativamente. Porém, existe uma lacuna atual documentada: a maioria dos ambientes não consegue alimentar áudio nativamente ao modelo principal ainda, roteando-o via API por enquanto.
Análise Panorama IA
O Qwen3.8-Omni-Flash representa evolução significativa na estratégia de processamento de mídia em modelos multimodais. A abordagem agêntica—onde o modelo decide ativamente o que processar em vez de consumir sequencialmente tudo—reduz custos operacionais substancialmente, especialmente relevante em aplicações com vídeos longos. A redução de 45,7% de tokens no OmniVideoBench enquanto melhora a precisão demonstra ganho em eficiência e qualidade.
Para empresas e desenvolvedores, a importância está na combinação de contexto amplo (1M tokens), capacidades agênticas e custos reduzidos. Comparativamente, o modelo compete diretamente com soluções como o Gemini 3.8 Flash com Extended Thinking para agentes, que também oferece capacidades de raciocínio e processamento de múltiplas modalidades.
A limitação crítica permanece na disponibilidade: sem pesos abertos, o modelo é exclusivamente acessível via API. Isso contrasta com modelos base como Qwen3.8-Flash-Next, disponibilizados com pesos abertos. Para quem necessita auto-hospedagem ou customização local profunda, essa restrição é significativa. Além disso, todos os números de desempenho fornecidos provêm da Alibaba, destacando a importância de validação independente antes de decisões de implementação em produção.
Observar a seguir: (1) se resultados independentes confirmarão as alegações de desempenho; (2) quando pesos abertos serão disponibilizados, se houver; (3) como a integração com agentes em ambientes específicos (CodeBuddy, Qoder etc.) evoluirá; e (4) como a redução de custos de vídeo impactará casos de uso em escala, especialmente em processamento de conteúdo educacional e análise de arquivos audiovisuais.
Fonte: MarkTechPost
Sobre o autor