A Contrastive-LM lançou o CLM-8B, o primeiro modelo aberto de uma nova classe chamada Contrastive Language Models (CLMs). Diferente dos modelos tradicionais que geram texto, o CLM-8B recebe um conjunto de ações candidatas e um estado atual, depois retorna probabilidades para cada ação. O modelo compete diretamente com Jev, um sistema proprietário da TypeSafe AI, e alcança latências significativamente menores em testes de zero-shot.
Como funciona o CLM-8B
O CLM-8B não gera sequências de texto. Em vez disso, ele implementa uma arquitetura baseada em encoders que mapeia estados e ações para um espaço de embeddings compartilhado. O modelo utiliza uma espinha dorsal congelada de Qwen3-8B e adiciona duas cabeças de projeção treináveis, cada uma com 20 milhões de parâmetros. Durante a inferência, o CLM calcula a probabilidade de cada ação candidata através do produto escalar entre os embeddings do estado e da ação, depois aplica softmax para produzir uma distribuição de probabilidades.
A arquitetura segue três tipos de consultas compatíveis com a API da TypeSafe:
- Noul: retorna a probabilidade de uma declaração ser verdadeira
- Choice: seleciona uma opção entre um conjunto declarado, com probabilidades associadas
- Score: retorna um nível esperado em uma escala ordenada
Um cliente Python permite que requisições escritas para a API da TypeSafe sejam reproduzidas diretamente no CLM, facilitando migração e testes comparativos. O repositório GitHub do projeto disponibiliza o CLM-8B atrás de uma API compatível com TypeSafe.
Treinamento e desempenho
O CLM-8B foi treinado em três etapas usando dados públicos e sintéticos. Na pré-treinagem, o modelo aprendeu com aproximadamente 60 milhões de pares pergunta-resposta do conjunto Nemotron DQA, atingindo 52,1% de precisão top-1 em cerca de 100 mil questões retidas. Na etapa intermediária, treinamento adicional com 30 milhões de negativas difíceis sintéticas geradas pelo Gemini 2.5 Flash-Lite elevou a precisão para 69,2%. Por fim, pós-treinamento em aproximadamente 1 milhão de trajetórias de agentes extraídas do Agent Data Protocol, Endless-Terminals e LiteCoder-Terminal-SFT otimizou o comportamento em cenários de agência.
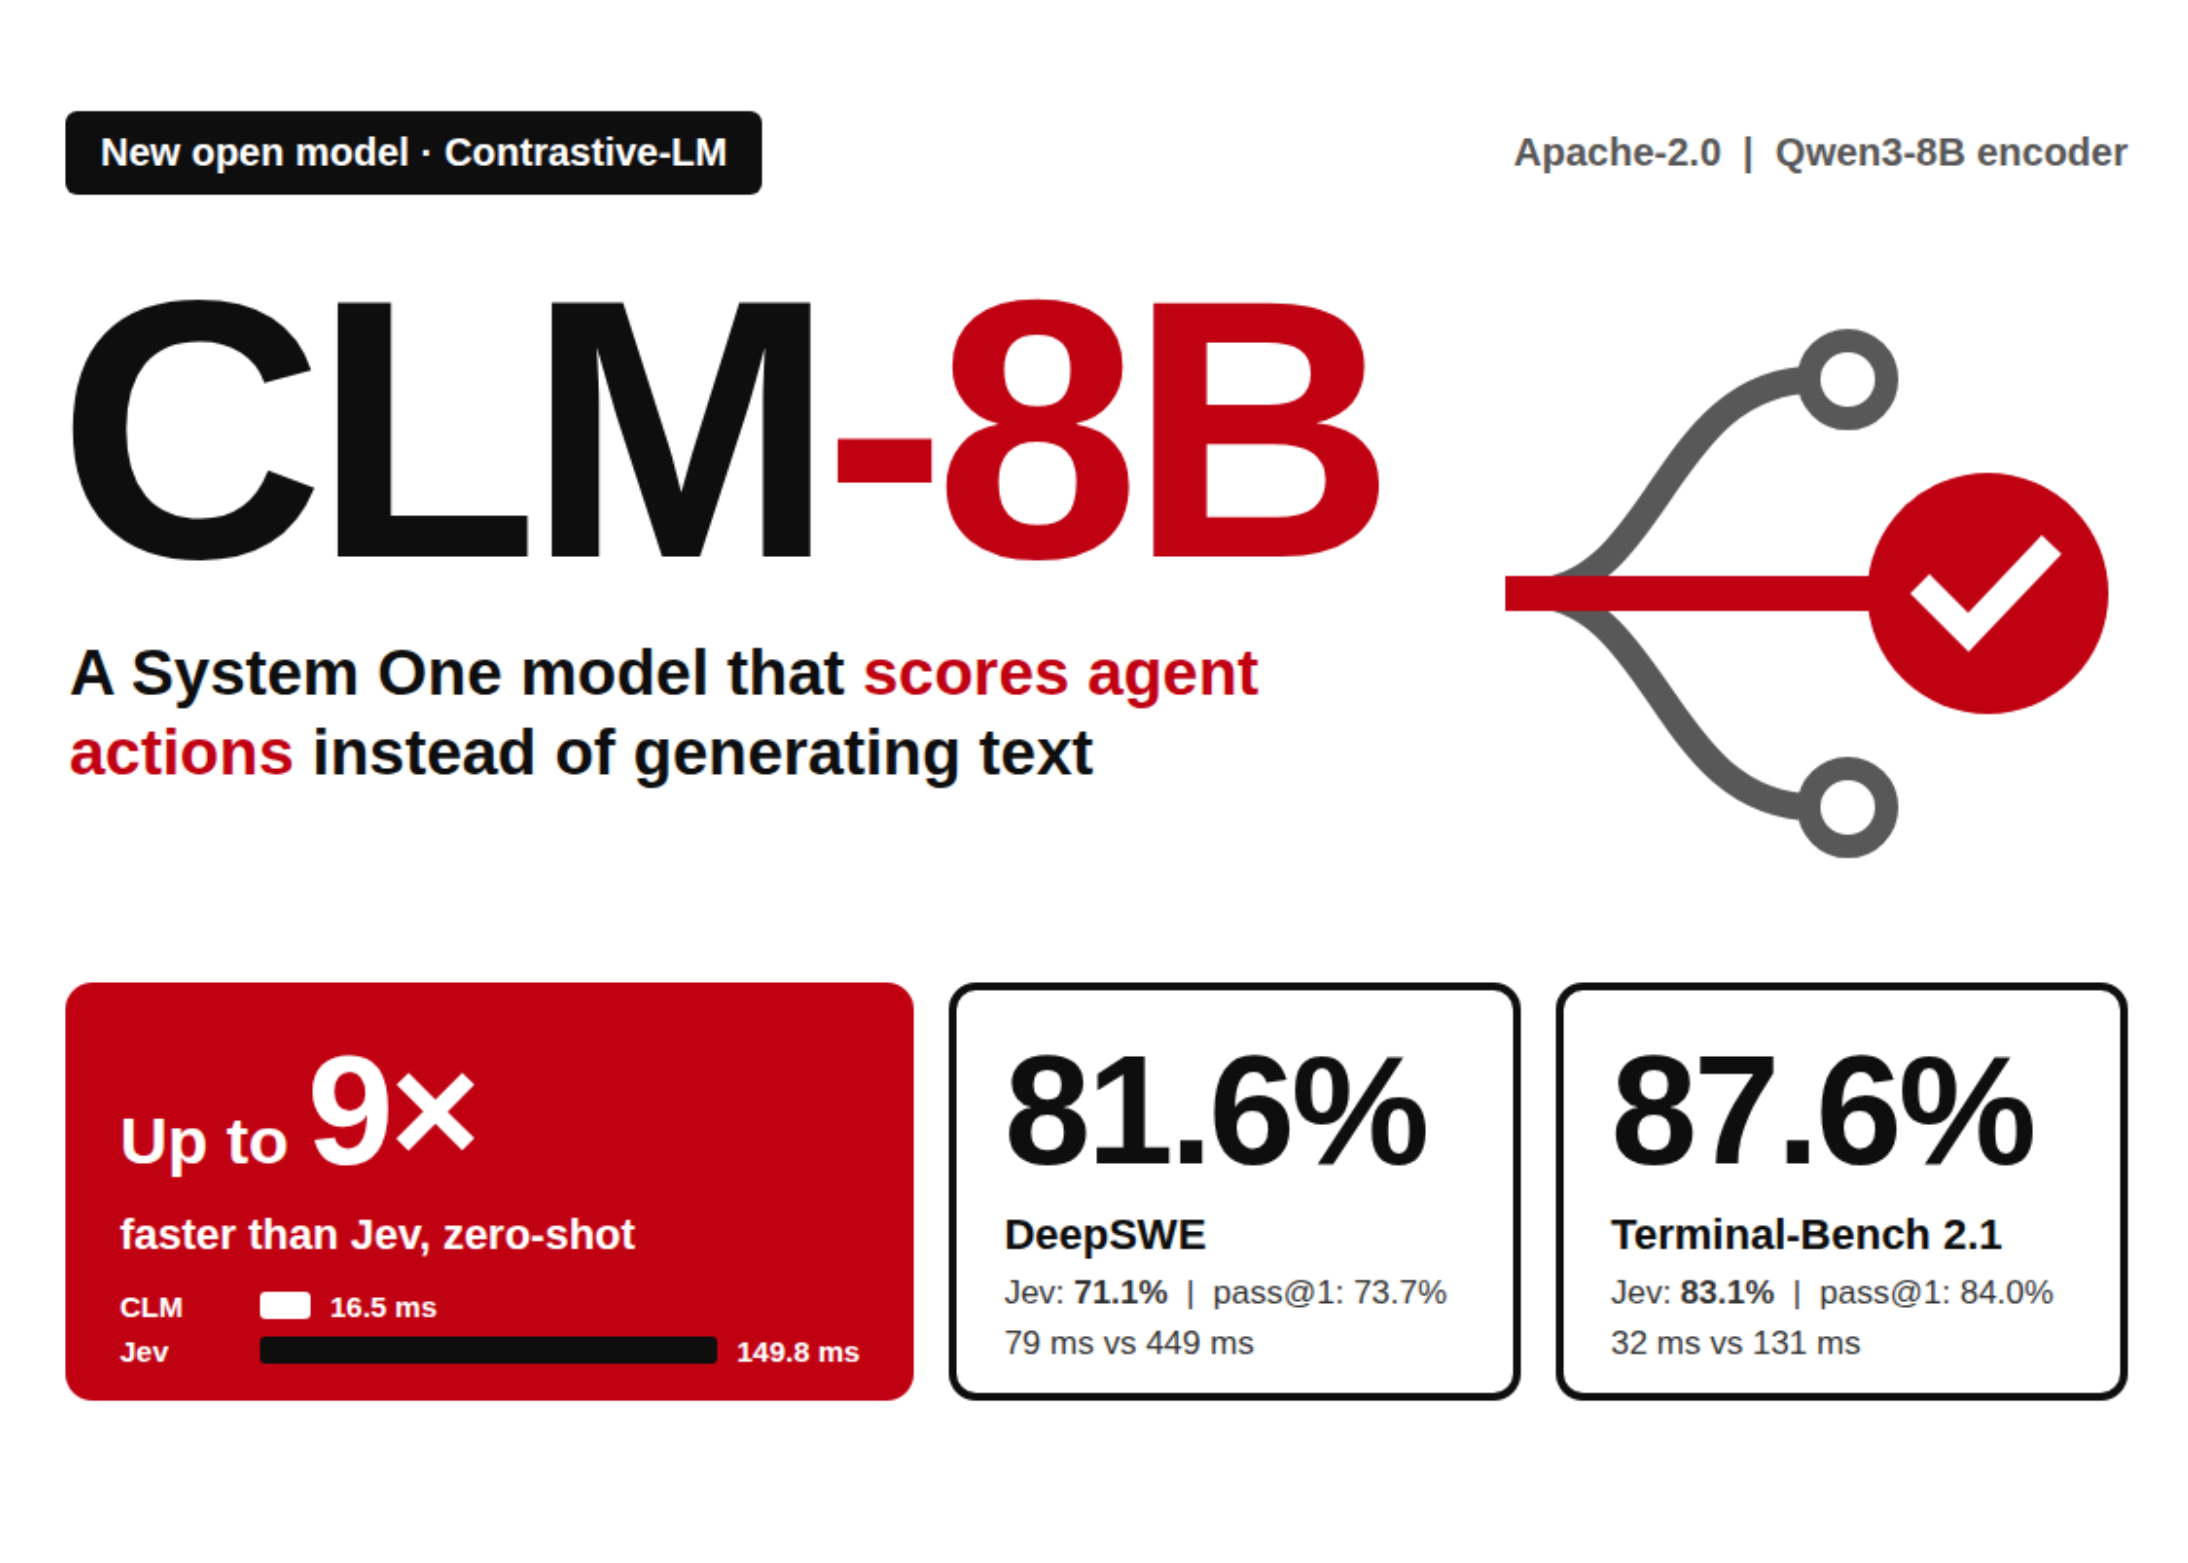
Quando usado como verificador em tarefas de seleção entre múltiplos candidatos, o CLM-8B alcançou resultados de estado-da-arte em subconjuntos retidos. No conjunto DeepSWE, atingiu 81,6% de precisão ao verificar os melhores 4 candidatos gerados pelo Opus 5. No Terminal-Bench 2.1, alcançou 87,6% de precisão ao verificar os melhores 5 candidatos gerados pelo Fable 5. É importante notar que estes são resultados em subconjuntos de 38 tarefas DeepSWE e 30 tarefas Terminal-Bench 2.1 retidas especificamente para avaliação, não submissões completas em leaderboards públicos.
Vantagens de latência e otimizações
Em testes de zero-shot, o CLM-8B executa até 9 vezes mais rápido que o Jev. Este ganho é particularmente pronunciado em cenários onde ações se repetem entre estados, como demonstrado no jogo T-Rex, onde o cache de vetores oferece maior benefício. O cabeçalho do modelo pesa apenas 75 MB e executa em uma única GPU NVIDIA sob Linux, com o encoder Qwen3-8B sendo servido através de vLLM.
Uma otimização arquitetural crucial é o cache de vetores de estado e ação. O sistema CLM-serve reserva um bloco de memória GPU similar ao KV-cache do vLLM e reutiliza vetores armazenados. Em um RTX 4090 com 3 ações candidatas, estados revisitados diminuem de 1,7 milissegundos para 0,6 milissegundos, uma redução de 65%. Quando usado com cabeças finas-ajustadas como verificador, o CLM executa 4,1 a 5,7 vezes mais rápido que Jev, embora estas medidas tenham sido obtidas em um acelerador H100.
Vale ressaltar que em testes de zero-shot gerais, o Jev frequentemente não alcança a taxa de acurácia de pass@1 em ambos os benchmarks, significando que selecionar uma ação usando Jev produz resultados piores que simplesmente aceitar um candidato aleatório. O CLM supera este problema mantendo latências competitivas.
Compatibilidade e limitações
O CLM-8B é distribuído sob licença Apache-2.0 e pode ser auto-hospedado, reduzindo preocupações com privacidade de dados comparado a serviços proprietários. Contudo, há limitações documentadas no desempenho comparativo. Em tarefas de chamada de ferramentas e WikiRacing, o CLM fica atrás do Jev em precisão, ainda que mantenha vantagens de latência. Este trade-off sugere que o modelo é particularmente otimizado para cenários de seleção entre candidatos pré-gerados, não para todas as classes de decisão agêntica.
O desempenho também depende do ajuste fino das cabeças de projeção. Os resultados de 81,6% e 87,6% mencionados anteriormente utilizam cabeças finas-ajustadas em dados de treinamento, não o checkpoint de zero-shot. A generalização para domínios completamente novos permanece uma questão em aberto.
Contexto no ecossistema de IA agêntica
O lançamento do CLM-8B ocorre em um momento onde sistemas de IA agêntica ganham destaque. Modelos como o Step 5 Preview da StepFun, com 600 bilhões de parâmetros e contexto de 1 milhão de tokens, estão ampliando as capacidades de raciocínio e planejamento de longo prazo. Enquanto isso, o CLM-8B segue uma estratégia ortogonal: em vez de aumentar escala ou contexto, ele especializa-se em uma tarefa específica—avaliar ações rapidamente—e consegue isto com apenas 8 bilhões de parâmetros através de treinamento contrastivo focado.
Jev, anunciado em acesso limitado antecipado em 15 de setembro de 2026, é um sistema proprietário que retorna valores tipados com probabilidades. O CLM-8B oferece uma alternativa aberta com interface compatível, possibilitando que desenvolvedores implementem agentes sem dependência de APIs proprietárias.
Análise Panorama IA
O CLM-8B representa uma abordagem pragmática para acelerar loops de agência. A decisão arquitetural de não gerar texto, mas apenas avaliar ações, simplifica o problema computacional: em vez de prever a próxima sequência de tokens, o modelo aprende a ordenar um conjunto fixo de candidatos. Isto é profundamente diferente da abordagem tradicional de modelos de linguagem generativos.
A importância prática é significativa: loops de agentes executam múltiplas vezes por segundo, e latência subcentiessegundal acumula em operações complexas. Ganhos de 9× em zero-shot, mantendo razoável desempenho em precisão, legitimam o modelo como uma alternativa viável ao Jev proprietário, particularmente para equipes que podem treinar cabeças de projeção em seus próprios dados de agentes.
Contudo, dois limites merecem observação. Primeiro, o desempenho em tarefas não-selecionistas, como chamadas de ferramentas, indica que o CLM-8B não é um substituto universal para modelos generativos em agência; é uma especialização. Segundo, os números de estado-da-arte em DeepSWE e Terminal-Bench 2.1 referem-se a subconjuntos retidos, não a leaderboards completos, o que merece confirmação em avaliações mais amplas.
O modelo também ilustra uma tendência emergente: à medida que IA agêntica amadurece, soluções especializadas que trocam flexibilidade por velocidade e eficiência ganham espaço. O futuro provavelmente incluirá ecossistemas mistos onde modelos generativos planejam e modelos como o CLM-8B executam verificação rápida e seleção de ações. A disponibilidade em código aberto acelera esta convergência.
Fonte: MarkTechPost
Sobre o autor