
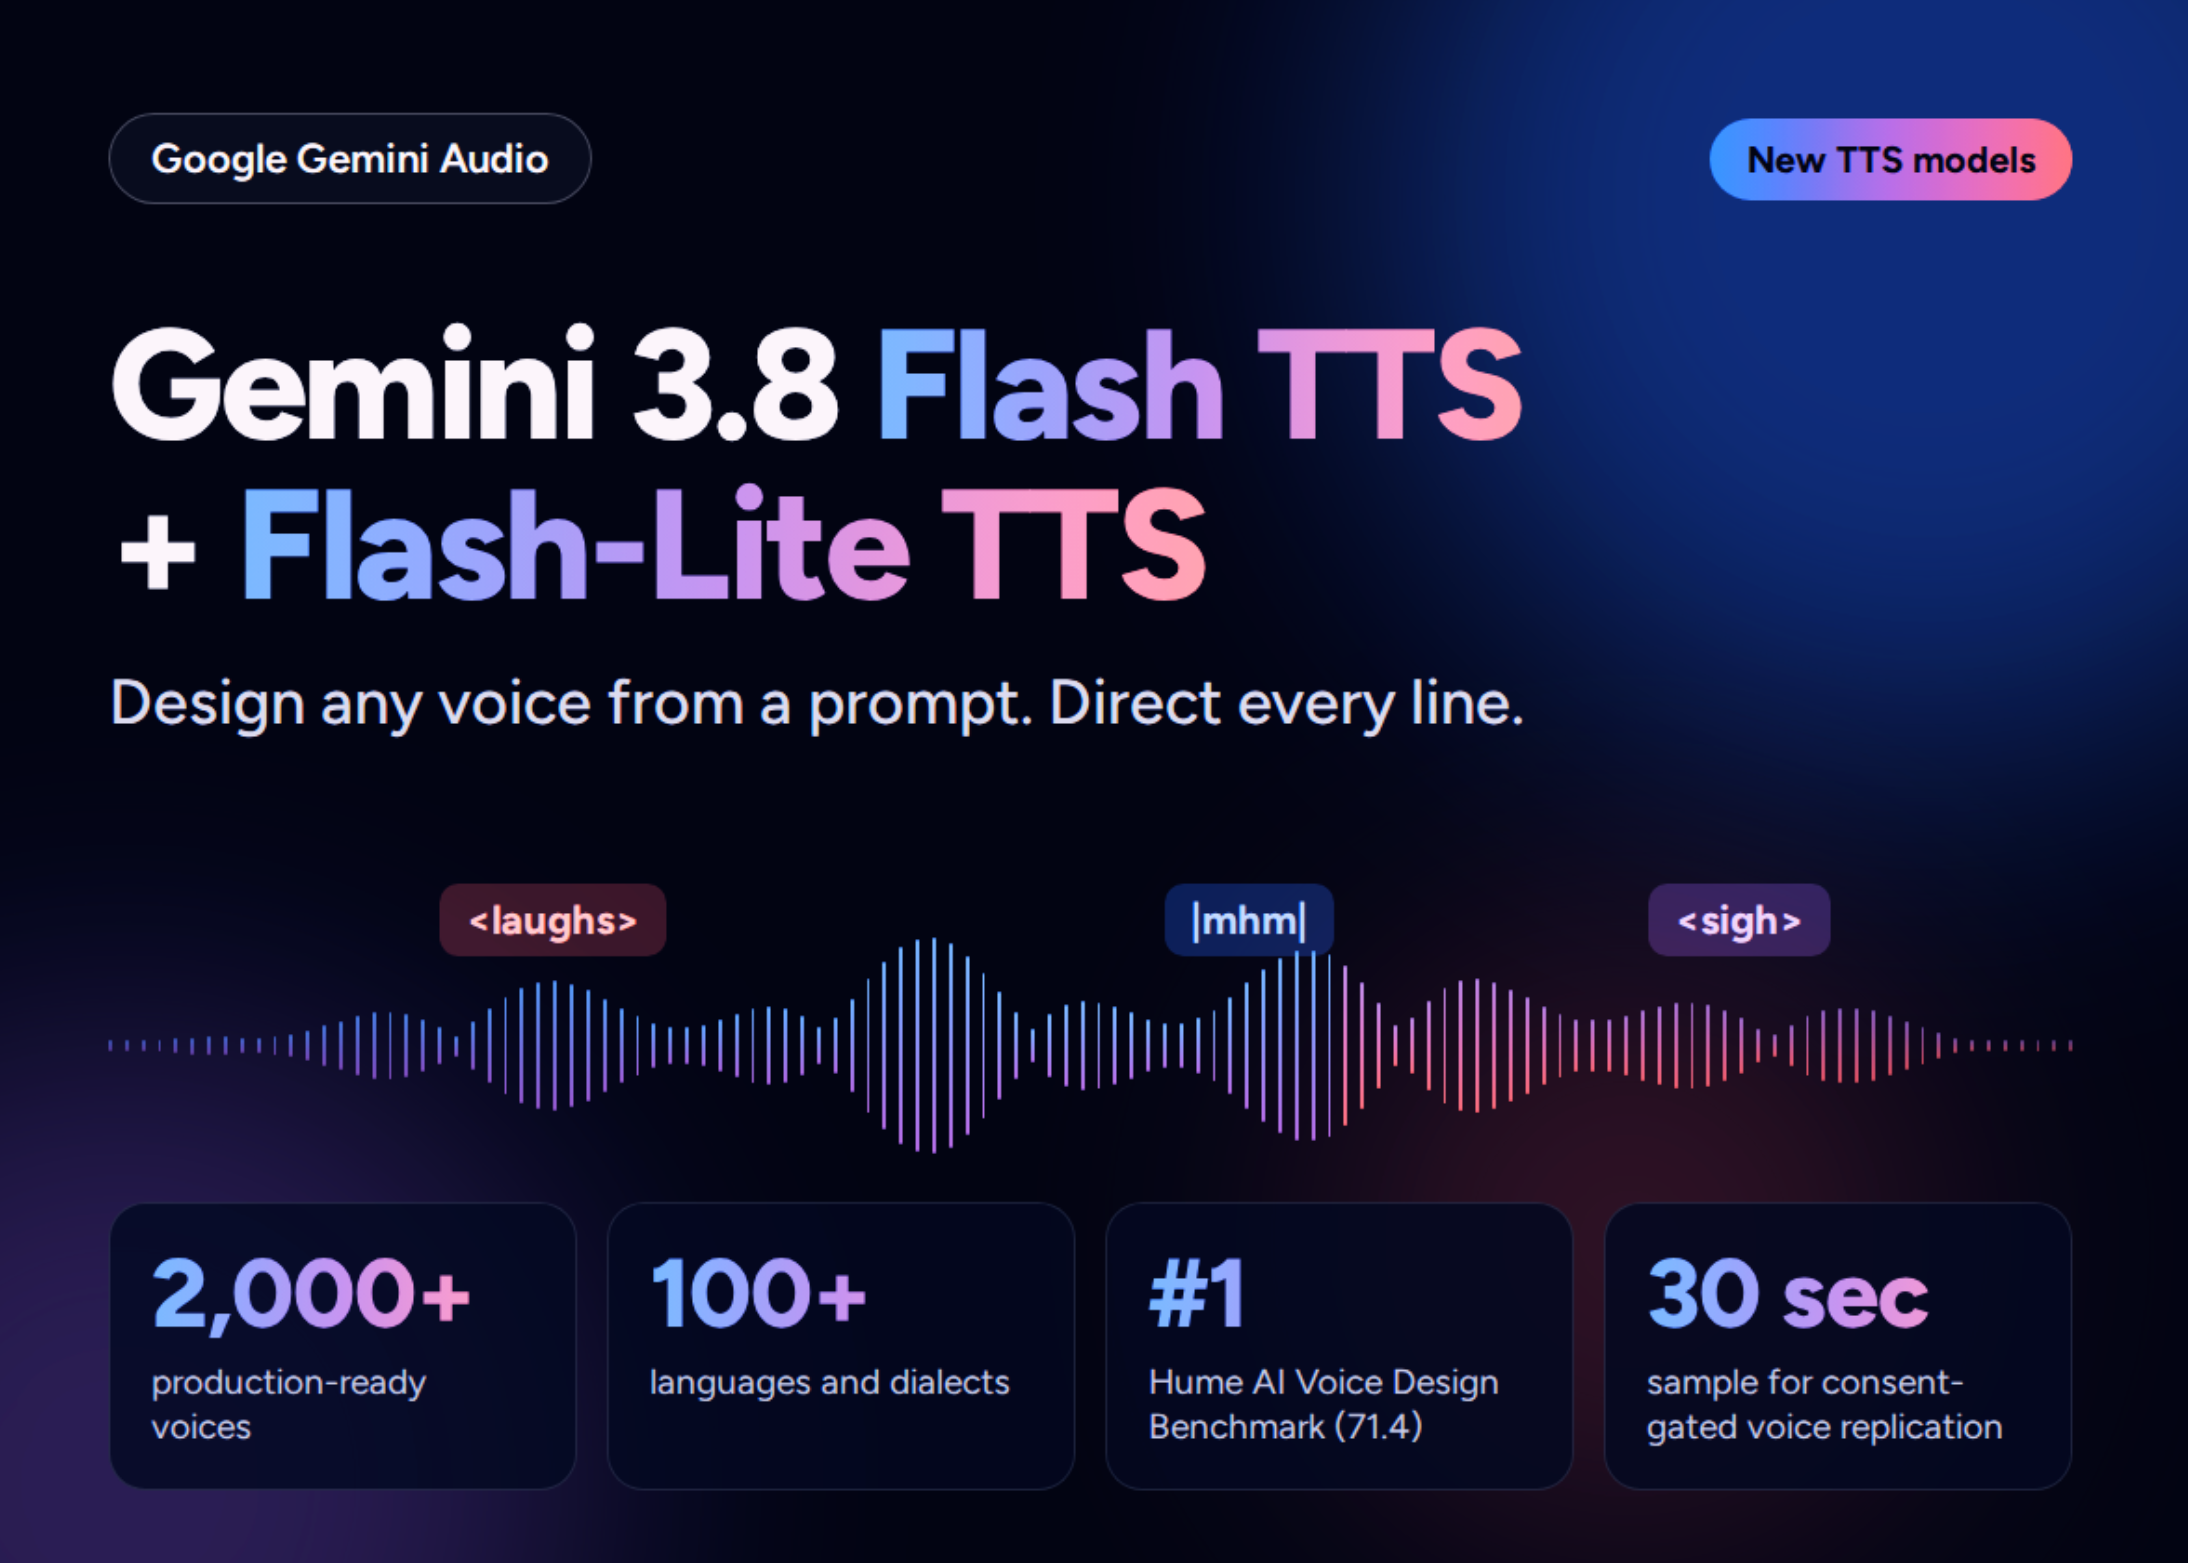
Google anunciou o lançamento de dois novos modelos de conversão de texto em fala: Gemini 3.8 Flash TTS e Gemini 3.8 Flash-Lite TTS. Ambos integram a família Gemini Audio e estarão disponíveis a partir de agora através da Gemini API e do Google AI Studio. Os modelos diferenciam-se no escopo de aplicação: o Flash TTS foi desenvolvido para direção criativa profunda e design de personagens, enquanto o Flash-Lite TTS visa produção em larga escala com eficiência de custos.
Arquitetura e capacidades dos novos modelos
A abordagem de dois níveis permite que desenvolvedores escolham o modelo adequado conforme a necessidade. O Gemini 3.8 Flash TTS é voltado para produção criativa em jogos, audiolivros imersivos, podcasts e mídia interativa, oferecendo controle granular sobre dicas de atuação, ritmo, variações de sotaque e backchanneling (interjeiçõesativas como reações naturais). Já o Flash-Lite TTS é posicionado para dubagem, criação de conteúdo de áudio e agentes de voz expressivos, com controle fino sobre tom, ritmo e nuances expressivas.
A geração de vozes por prompts representa a diferença técnica mais significativa em relação às versões anteriores do Gemini TTS. Enquanto a geração anterior oferecia 30 vozes originais pré-gravadas, o novo sistema funciona de forma generativa: o usuário descreve características como papel, sotaque e qualidade vocal em linguagem natural, e o modelo cria uma voz correspondente. Este mecanismo funciona em mais de 100 idiomas e dialetos, conforme demonstrado por exemplos como um DJ de Melbourne, um robô monótono e um dragão japonês presentes nos demos do Google.
Para reduzir a dependência exclusiva de geração, Google oferece uma biblioteca de 2.000+ vozes pré-produzidas, abrangendo variedades regionais como espanhol mexicano, francês quebequense e inglês escocês. As vozes customizadas podem ser salvas e reutilizadas com variação mínima entre projetos. Um recurso futuro, voice remixing, permitirá ajustar timbre, tom, ritmo e sotaque de vozes da biblioteca através de prompts.
Controle de performance e recursos de autenticidade
Ambos os modelos aceitam direções de palco escritas direto no script. O Gemini pode também dirigir a entrega a partir de pistas naturais contidas no texto. Para geração de áudio de longa duração, o sistema mantém consistência de qualidade vocal, ritmo e timbre ao longo de horas contínuas. Um recurso nativo de staging com dois locutores permite que um único script conduza uma conversação multi-turno com vozes distintas e separadas.
O modelo suporta rajadas vocais não-verbais como <laughs>, <sigh> e <gasp> para adicionar textura conversacional, além de backchanneling—interjeiçõesativas como “mhm” e “yeah”—para controlar batidas de reação e timing cômico. Estes elementos foram projetados especificamente para aumentar o realismo e a expressividade em cenários de áudio interativo.
Quanto à replicação de voz, o sistema constrói um perfil vocal consistente a partir de uma amostra de áudio de 30 segundos. A amostra deve ser da voz do usuário ou de uma voz cuja utilização ele possua direitos. Google implementa proteção adicional exigindo uma gravação de consentimento verbal do proprietário da voz, que é comparada contra o falante de referência. Todo clipe gerado pelos modelos Gemini Audio carrega uma marca d’água SynthID imperceptível, incorporada diretamente no arquivo de áudio. As vozes replicadas recebem também credenciais de conteúdo C2PA.
Desempenho medido e disponibilidade
Segundo avaliações independentes da Hume AI, o Gemini 3.8 Flash TTS classifica-se em primeiro lugar no Voice Design Benchmark com pontuação de 71,4. No mesmo benchmark, o Flash TTS alcança 60,8 em modelagem de sotaque, liderando a categoria. No Hume AI Overall Quality Index, Flash TTS ocupa a primeira posição e Flash-Lite TTS a segunda. Em testes de preferência cega (Voice Arena), ambos os modelos ocupam as principais posições em japonês, português brasileiro, vietnamita, árabe padrão moderno, espanhol mexicano e hindi.
Os modelos estão disponíveis imediatamente através da Gemini API e do Google AI Studio. O acesso é exclusivamente via API, sem disponibilidade de pesos abertos para auto-hospedagem. O acesso Enterprise via Gemini Enterprise foi anunciado como “em breve”. Nos playgrounds do AI Studio, os identificadores de modelo são “gemini-3.8-flash-tts” e “gemini-3.8-flash-lite-tts”. Nota importante: a replicação de voz e certos recursos de voice remixing ainda não estão disponíveis em diversas regiões, incluindo Reino Unido, Espaço Econômico Europeu e Índia.
Recursos principais comparados
| Recurso | Flash TTS | Flash-Lite TTS |
|---|---|---|
| Caso de uso principal | Criação criativa, personagens, mídia interativa | Dubagem em larga escala, agentes de voz |
| Biblioteca de vozes | 2.000+ vozes pré-produzidas + geração por prompt | 2.000+ vozes pré-produzidas + geração por prompt |
| Controle de performance | Granular (atuação, ritmo, sotaque, backchanneling) | Fino (tom, ritmo, nuance expressiva) |
| Ranqueamento Hume AI | 1º no Voice Design Benchmark (71,4) | 2º no Overall Quality Index |
| Eficiência de custo | Modelagem criativa otimizada | Otimizado para volume alto |
Análise Panorama IA
O lançamento dual do Flash TTS e Flash-Lite TTS marca uma mudança estratégica no posicionamento do Google em síntese de voz. Ao invés de oferecer um único modelo genérico, a empresa segmenta o mercado em dois perfis de usuário: criadores que priorizam qualidade e controle expressivo, e operações em escala que priorizam eficiência de custos e velocidade de processamento. Isto é relevante porque reduz desperdício de recursos computacionais—não faz sentido usar um modelo altamente expressivo para dubagem de conteúdo repetitivo.
A transição de 30 vozes originais para um sistema generativo de 2.000+ vozes customizáveis amplia drasticamente a flexibilidade criativa. O design de voz por prompts em linguagem natural derruba uma barreira técnica: antes, mesmo com acesso a APIs, usuários precisavam navegar bibliotecas fixas ou ajustar parâmetros técnicos. Agora, um roteirista pode descrever “uma vendedora de Vancouver dos anos 80” e o modelo gera uma voz coerente com essa descrição. Isto transforma a síntese de voz de um recurso paramétrico em um recurso baseado em intenção criativa.
O ranqueamento no benchmark da Hume AI confere credibilidade mensurável, mas convém observar que benchmarks independentes podem não capturar todos os casos de uso reais. A disponibilidade de acesso apenas via API (sem open weights) mantém Google como intermediária de custo e contratos comerciais, diferentemente de modelos open-source que permitem auto-hospedagem. Isto é uma limitação operacional para quem busca máxima independência técnica.
As restrições regionais em recursos como replicação de voz e remixing sugerem abordagens diferentes de conformidade regulatória entre mercados. Usuários no EEA, Reino Unido e Índia terão capacidades reduzidas, o que fragmente a experiência de produto globalmente. A marca d’água imperceptível SynthID e as credenciais C2PA respondem a preocupações crescentes sobre autenticidade de áudio gerado por IA, um ponto positivo para adoção em setores que requerem rastreabilidade.
Para observar nos próximos meses: como os preços de API se comparam entre Flash TTS e Flash-Lite TTS na prática, qual será o impacto real do voice remixing quando lançado, e se as restrições regionais serão expandidas ou reduzidas conforme as regulações locais evoluem. A qualidade em português brasileiro foi reconhecida nos testes, o que torna este lançamento particularmente relevante para produtoras de conteúdo no Brasil.
Fonte: MarkTechPost
Sobre o autor




