
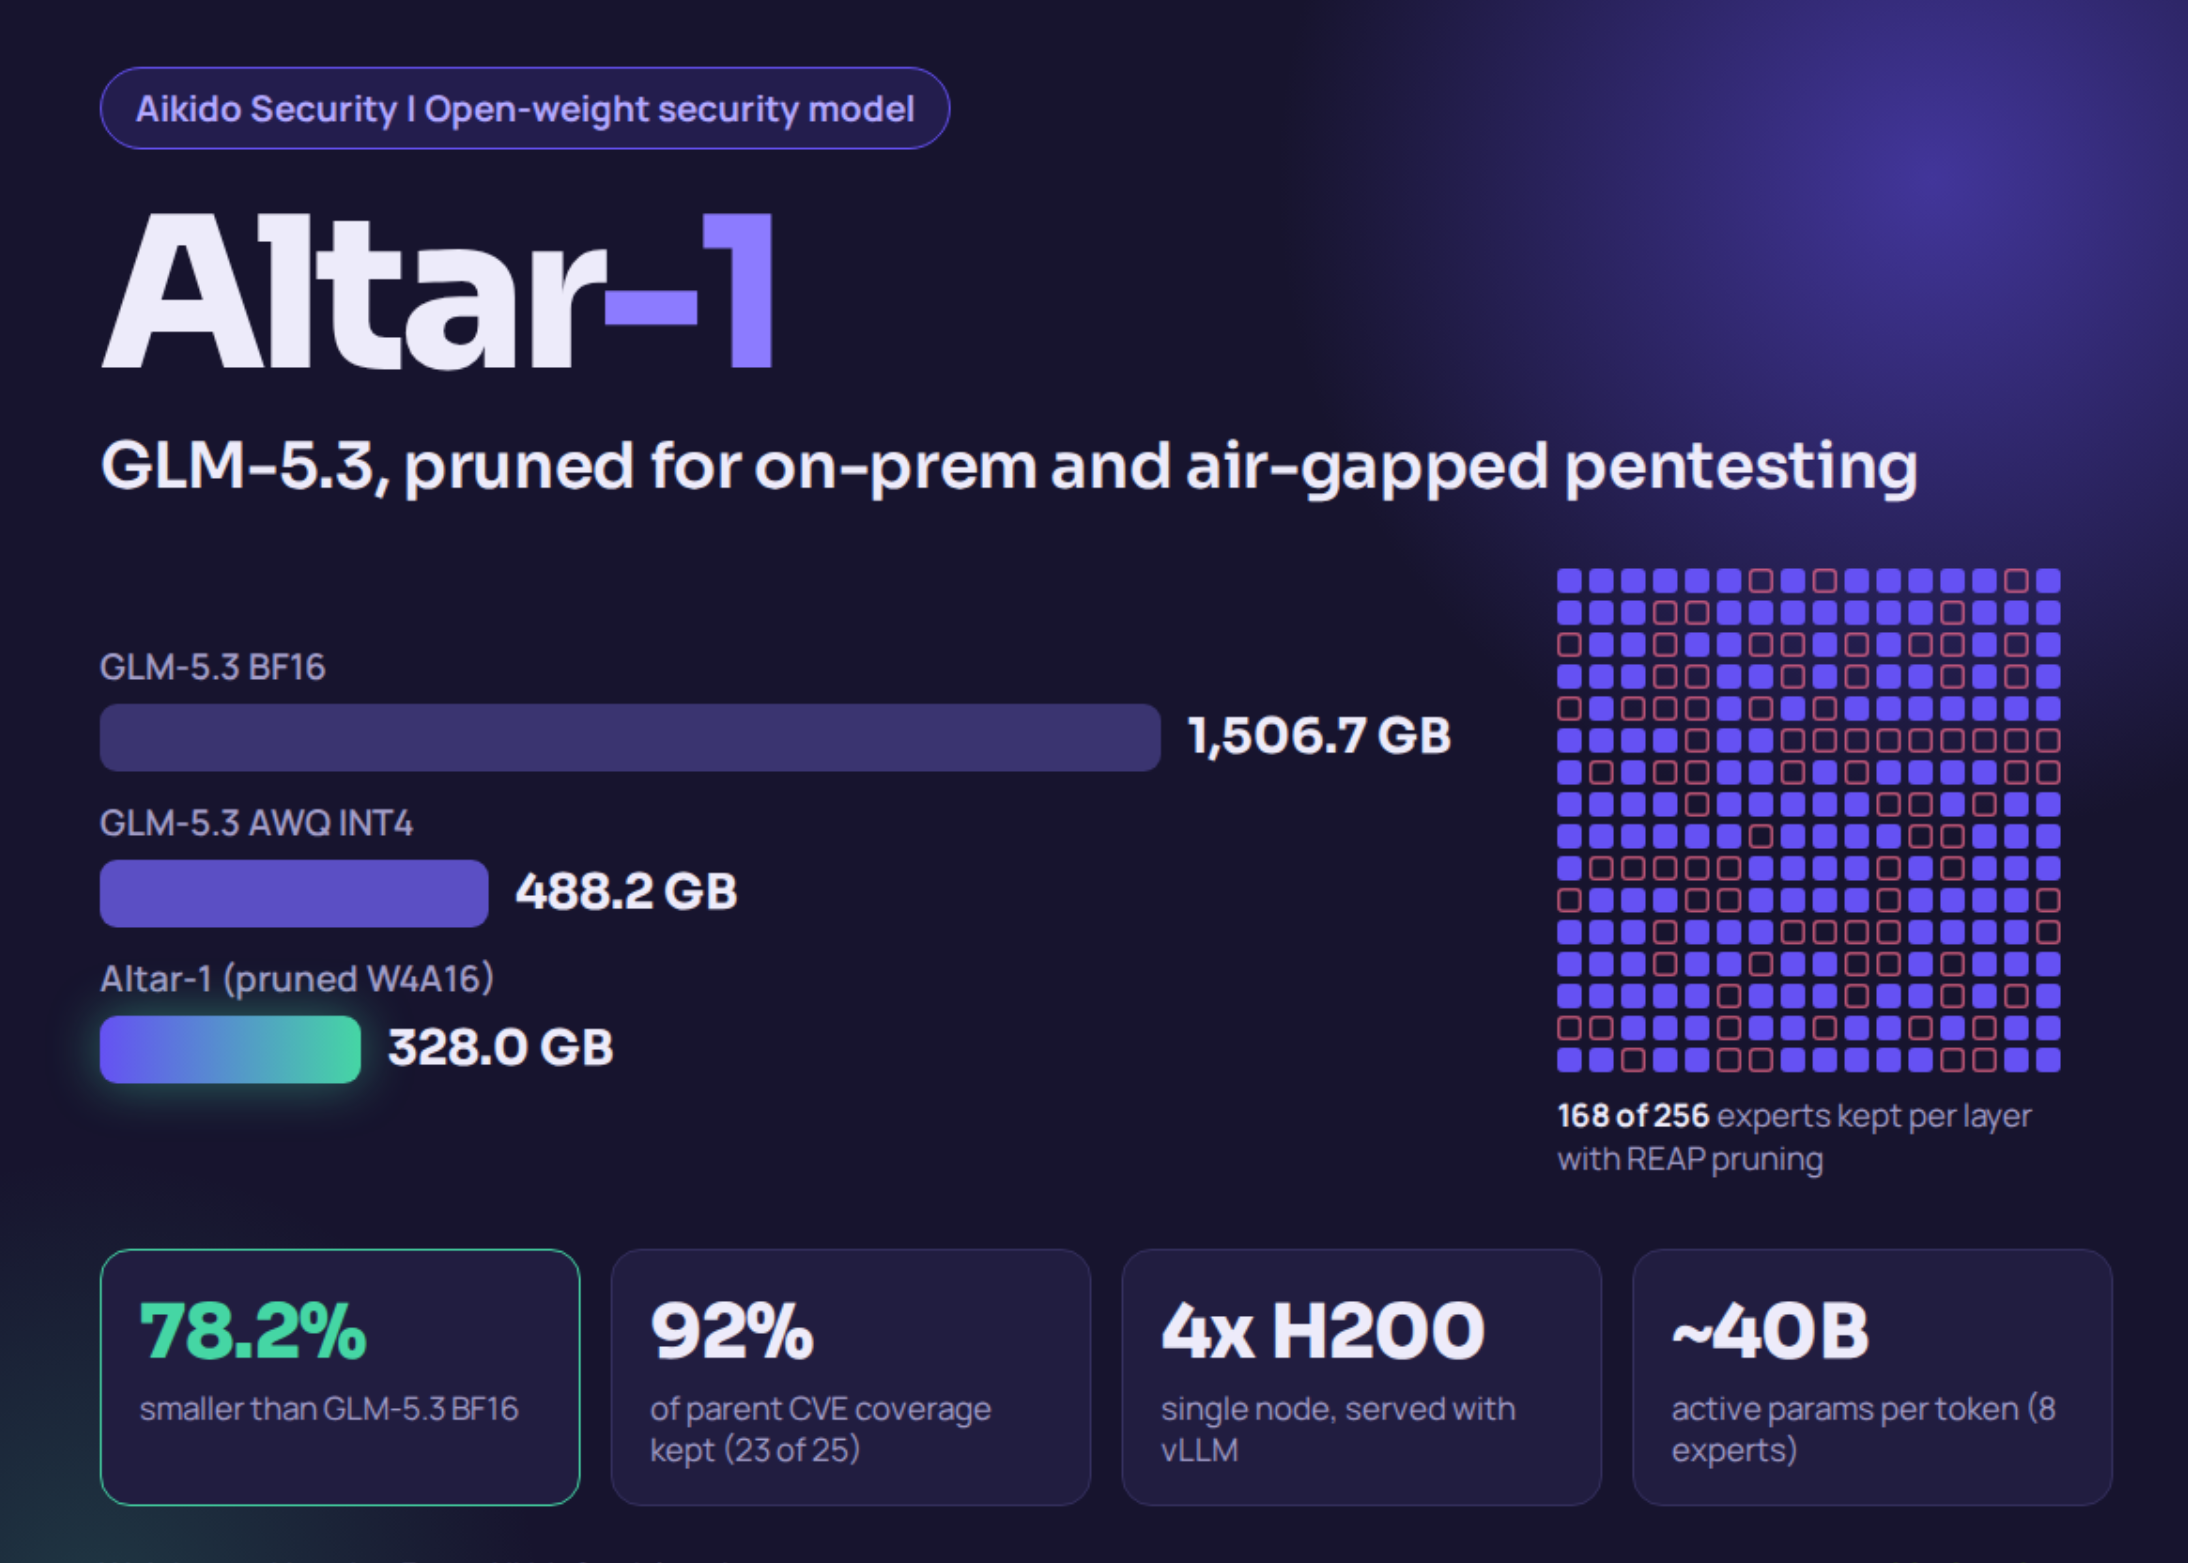
A Aikido Security divulgou Altar-1, seu primeiro modelo de segurança open-weight (pesos abertos ao público). Trata-se de uma versão comprimida do GLM-5.3 da Z.AI, projetada para funcionar em infraestrutura controlada pelo cliente, sem dependência de serviços na nuvem de terceiros. O modelo alimenta a Aikido Machine, uma ferramenta de teste de penetração autônomo (pentesting) para redes locais e ambientes air-gapped, onde não há conexão à internet.
Compressão agressiva mantendo capacidade funcional
O GLM-5.3 original é um modelo de mistura de especialistas (Mixture-of-Experts, ou MoE) com 753 bilhões de parâmetros. Cada token é roteado para 8 de 256 especialistas por camada, resultando em aproximadamente 40 bilhões de parâmetros ativos por vez. O modelo original ocupa 1.506,7 GB quando armazenado em precisão BF16, impossibilitando sua execução em muitos ambientes on-premises ou isolados.
A Aikido aplicou duas etapas de compressão para chegar aos 328 GB finais, uma redução de 78,2%:
- Quantização (AWQ-INT4): começou pelo checkpoint cyankiwi GLM-5.3-AWQ-INT4, armazenando pesos dos especialistas roteados em 4 bits, mantendo ativações em 16 bits. Camadas de atenção, especialista compartilhado, camadas densas e cabeçalho permaneceram em BF16.
- Poda de especialistas (REAP): usou a técnica Router-weighted Expert Activation Pruning do Cerebras, que avalia cada especialista não apenas pela frequência de seleção, mas pelo peso do roteador e magnitude de saída. Mantém 168 de 256 especialistas por camada, removendo 88 (34,4%). Nenhum retreinamento foi necessário.
O roteamento permanece inalterado: continua selecionando 8 especialistas por token, agora do conjunto reduzido de 168. A calibração usou rastreamentos do harness de pentesting da Aikido, além de textos de codificação, chamadas de ferramentas, raciocínio e Wikipédia multilíngue. A empresa afirma que dados de clientes não foram utilizados.
Desempenho em fidelidade e detecção de vulnerabilidades
Métricas técnicas revelam impacto moderado da compressão. Altar-1 apresenta divergência de Kullback-Leibler (KL) de 0,506 nats contra o BF16 completo em um painel de 25 prompts selado. Uma construção equivalente em formato EXL3 alcançou 0,511, sugerindo que formatos ainda mais comprimidos poderiam ser viáveis.
Em testes no benchmark interno de CVE da Aikido, que cobre 32 vulnerabilidades conhecidas em 30 repositórios com 3 execuções por caso, a poda de especialistas custou aproximadamente 1 ponto de recall em relação ao checkpoint AWQ, sem perda de cobertura. Comparado ao modelo pai completo, Altar-1 mantém 23 de 25 vulnerabilidades cobertas (92%) com recall 5,2 pontos inferior—de 65,6% para 60,4%.
A empresa também relatou que Altar-1 descobriu uma vulnerabilidade crítica válida durante um teste de penetração em produção de cliente. Trata-se de um resultado único informado pelo fornecedor, não de uma avaliação independente.
Implantação, requisitos técnicos e limitações
Altar-1 requer GPUs Hopper (H100 ou H200) e foi testado em um nó com 4x NVIDIA H200. Os 328 GB de pesos deixam espaço para um cache KV de 128k tokens em tamanhos de lote em produção. O vLLM seleciona automaticamente o kernel Marlin MoE. Uma configuração com 4x H100 de 80 GB cada totaliza apenas 320 GB de memória, insuficiente para os 328 GB de pesos—exigindo H200s de 141 GB ou modelo com compressão adicional.
O benchmark de CVE da Aikido é reconhecidamente estreito. Mede redescoberta de CVE direcionada dentro de um pipeline que usa outros modelos nas etapas circundantes, não cobre descoberta cega, validação de exploração ou propostas de correção. Esta é uma limitação importante ao considerar a aplicabilidade prática em testes de penetração reais.
Altar-1 herda a licença GLM-5.3, que permite uso comercial, modificação e redistribuição. No entanto, operadores de Model-as-a-Service com receita superior a US$ 10 bilhões em 12 meses devem passar por revisão de segurança da Z.AI. O modelo é open-weight, não OSI-approved open source, uma distinção importante para certos contextos de conformidade.
Disponibilidade e próximos passos
Os pesos estão públicos no Hugging Face e já rodam com vLLM, tornando o modelo operacional imediatamente para organizações com infraestrutura H200 disponível. Altar-1 também alimenta Aikido Attack, AI Code Analysis e Deep Review—produtos da empresa que dependem de análise de código e segurança local.
A Aikido planeja experimentar formatos ainda menores como EXL3 para manter mais especialistas sem sacrifício de desempenho, além de fine-tuning de modelos especificamente otimizados para fluxos de segurança.
Análise Panorama IA
Altar-1 representa uma tentativa pragmática de resolver um problema real: organizações sob mandatos de residência de dados ou operando redes completamente isoladas não podem usar modelos de frontier (como GPT-4 ou Claude) sem comprometer segurança de informação, pois código-fonte e achados viajam para servidores de terceiros. Modelos abertos tradicionais, porém, têm sido pouco práticos em escala—seus pesos consumem memória GPU incompatível com a maioria das infraestruturas existentes.
A redução de 78,2% em tamanho, mantendo 92% da cobertura de vulnerabilidades, aponta um equilíbrio viável entre portabilidade e funcionalidade. Para um banco sob mandato de residentização de dados ou operador de infraestrutura crítica (OT) sem rota à internet, trata-se de opção antes indisponível. Ainda assim, o desempenho não é idêntico ao modelo pai: a queda de 5,2 pontos em recall pode ser significativa dependendo do contexto operacional.
O benchmark de CVE da Aikido, embora transparente, é limitado em escopo—não avalia descoberta cega ou qualidade de propostas de correção, apenas redescoberta direcionada. Organizações considerando adotar Altar-1 devem testar sua capacidade de descobrir vulnerabilidades próprias de seu patrimônio de software, não apenas CVEs conhecidas.
A obrigatoriedade de GPUs Hopper também representa barreira: H200s ainda são caras e escassas em muitos datacenters corporativos. A Aikido sinaliza interesse em EXL3 e quantizações ainda menores, sugerindo que versões futuras possam rodar em hardware menos exigente. Enquanto isso, H100s são tecnicamente insuficientes, limitando adoção imediata a um subconjunto de infraestruturas.
A importância maior é o precedente: demonstra que poda de especialistas sem retreinamento é viável para modelos MoE de larga escala, abrindo caminho para futuras versões menores de outros gigantes (GLM, Llama, Mixtral) e acelerando a viabilidade de modelos de IA em ambientes restritivos de dados.
Fonte: MarkTechPost
Sobre o autor




