
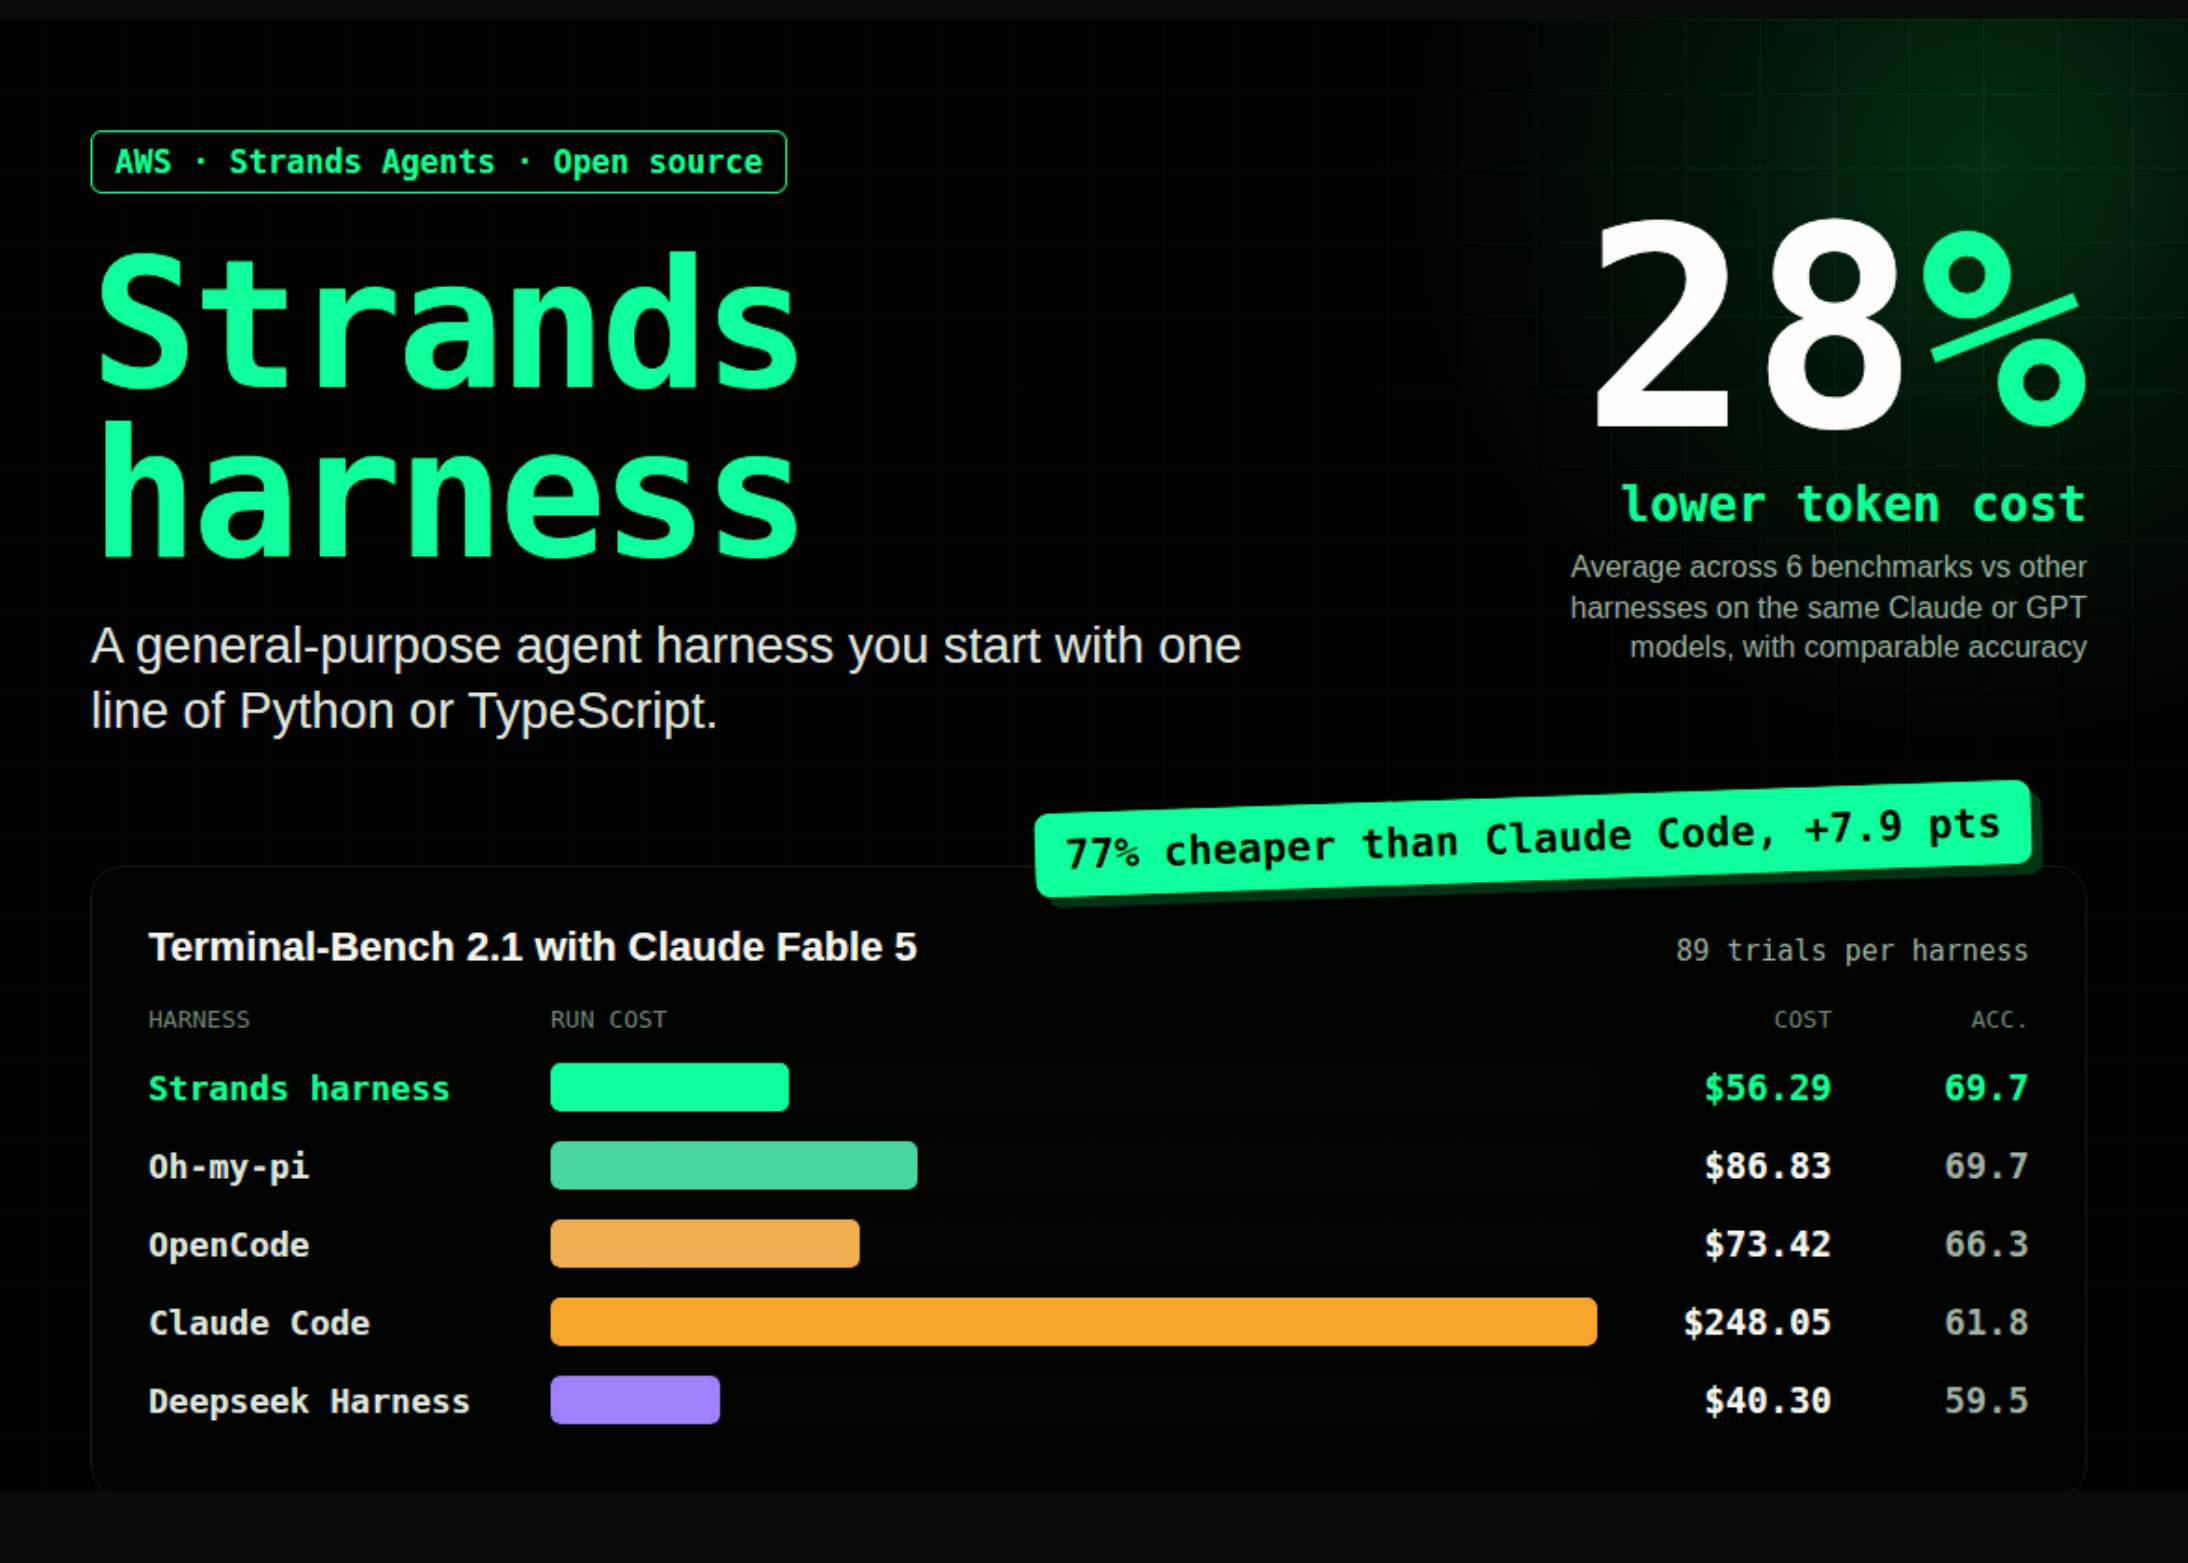
O time Strands Agents da AWS lançou o Strands Harness, um framework open-source para construir agentes de inteligência artificial que reduz o custo de processamento em 28% em relação a outras soluções, mantendo acurácia comparável. A solução responde a um problema comum entre desenvolvedores: ideias de agentes que funcionam bem em plataformas integradas como Claude Code ou Codex enfrentam dificuldades quando reconstruídas com loops próprios.
O que é o Strands Harness e como funciona
Um harness é a camada de sistema que envolve o modelo de linguagem: o loop de execução, ferramentas, tratamento de contexto, memória e recuperação de erros. O Strands Harness empacota esses componentes em padrões funcionais prêt-à-porter, disponíveis sob licença Apache 2.0 para Python e TypeScript. A instalação é simples: pip install strands-harness ou npm install @strands-agents/harness.
O framework funciona tanto em ambientes locais quanto em provedores de nuvem. Uma chamada única de create_harness() retorna um agente configurado que:
- Executa em modelos de raciocínio atuais via Amazon Bedrock, Anthropic, OpenAI, Google, Ollama ou LiteLLM
- Fornece ferramentas nativas: shell, manipulação de arquivos (leitura, escrita, edição) e acesso web, em vez de uma ferramenta específica por tarefa
- Transfere resultados volumosos de ferramentas para arquivos e aplica cache em partes reutilizáveis de cada requisição
- Mantém memória de longo prazo entre execuções e retoma conversas usando um ID de sessão
- Delega subtarefas abertas a um agente auxiliar integrado e rastreia trabalho multietapa com checklist
- Carrega Agent Skills automaticamente quando as encontra
O harness também inclui suporte para implantação em múltiplos provedores: AWS, Google Cloud, Azure, Cloudflare e Modal. Um arquivo de skills integradi auxilia o agente a gerar configurações de deployment.
Resultados de eficiência: benchmarks e comparações
O time Strands executou avaliações distribuídas usando Harbor, framework de avaliação dos criadores do Terminal-Bench. Os testes cobriram seis benchmarks diferentes: ALFWorld, ContextBench, GAIA, WebShop, τ²-bench e Terminal-Bench 2.1.
Os principais resultados em comparação com concorrentes, medidos por custo médio por tarefa:
- Contra Claude Code (Terminal-Bench 2.1): Strands Harness custou 77% menos e marcou 7,9 pontos a mais em acurácia (89 testes por harness)
- Contra Oh-my-pi: Strands Harness atingiu 69,7% de acurácia com 54% menos custo
- Contra DeepSeek Harness: DeepSeek foi 14% mais barato, mas marcou menor em todos os benchmarks, ficando 10,2 pontos abaixo em Terminal-Bench 2.1
- Pontuação máxima: Claude Opus 5 rodando em Strands Harness atingiu aproximadamente 85% de acurácia
Conforme mencionado pelo time, dois outros harnesses open-source também apresentaram bom desempenho em custo e acurácia contra Claude Code. A inclusão de comparadores na análise resultou na figura geral de 28% de economia em tokens.
Como o Strands Harness reduz custos: gestão de contexto
A eficiência vem principalmente da gestão inteligente de contexto. Três regras estruturam esse trabalho:
- Resultados de ferramentas acima de 1.500 tokens são truncados automaticamente
- Compactação (sumarização) é acionada quando o uso de contexto ultrapassa 85%
- Recuperação de contexto executa dentro do loop se a janela transborda
Essas práticas alinham-se com pesquisa independente recente. O estudo HarnessTax comparou Claude Code, Codex CLI e Pi em sete modelos diferentes, descobrindo que a escolha de harness mal afetava as taxas de sucesso, enquanto o mesmo modelo podia atingir resultados similares a custos até 5 vezes maiores. O time Strands sinalizou que um artigo de acompanhamento sobre seus benchmarks será publicado em breve.
Customização e ferramentas disponíveis
Embora o harness seja construído como solução genérica, suporta profunda customização. Desenvolvedores podem substituir qualquer padrão, trocar modelos, adicionar ferramentas ou trocar componentes até o nível do Strands Harness SDK subjacente. Como a biblioteca funciona como dependência, o agente prototipado em um laptop é o mesmo implantado em produção.
O time também lançou a Strands CLI (npm install @strands-agents/strands-cli), que permite prototipar agentes em linguagem natural. Em um exemplo prático, um agente recebeu instruções para adicionar o servidor MCP Playwright e medir latência de carregamento de vídeo em uma página web. O comando /export gerou o código completo do harness em Python ou TypeScript, já com o Playwright MCP incluído. Um engenheiro do time também utilizou a CLI para construir uma aplicação desktop que dispara execuções do Strands Harness remotamente.
Limitações e considerações importantes
A comparação com DeepSeek Harness revela um trade-off central: enquanto DeepSeek oferece custo ainda menor, a redução de acurácia em todos os benchmarks é significativa. O gráfico de resultados explicitamente nota que a inclusão de DeepSeek Harness reduziu a economia geral reportada para 28%, o que significa que sem essa comparação a vantagem percentual seria maior. Portanto, a métrica de 28% reflete um cenário conservador e realista de competição no mercado.
Outro ponto: o desempenho varia bastante por benchmarks e modelos. A maior pontuação (Claude Opus 5, aproximadamente 85%) não é garantida em todos os casos de uso. Desenvolvedores devem testar em seus próprios cenários antes de assumir os números reportados como universais.
Análise Panorama IA
O lançamento do Strands Harness endereça um gap real no mercado de agentes IA. Enquanto plataformas integradas como Claude Code abstraem toda a complexidade de construir um loop de agente, empresas que implementam seus próprios sistemas frequentemente reinventam a roda em otimizações de contexto, tratamento de memória e fallbacks. Uma biblioteca pronta que codifica boas práticas reduz barreiras técnicas e de tempo para adotar arquiteturas agênticas.
A vantagem de 28% em custo de tokens é significativa em escala, especialmente para aplicações que rodam agentes continuamente. Se um agente típico de uma empresa gasta mil dólares por mês em tokens, uma redução de 28% economiza 280 dólares mensalmente, ou 3.360 dólares anualmente. Para operações em larga escala, o impacto composto é substancial.
A estratégia de disponibilizar sob Apache 2.0 com suporte a múltiplos provedores de modelo (Bedrock, OpenAI, Google, Anthropic, Ollama) reduz lock-in com um único provedor. Desenvolvedoras podem trocar modelos ou plataformas sem reescrever a arquitetura do agente. Isso é particularmente relevante quando novos modelos com melhor custo-benefício surgem regularmente no mercado.
Uma questão a observar: conforme mais harnesses open-source amadurecem (como indicado pelo desempenho de dois outros mencionados no texto), a diferença competitiva em custo tende a diminuir. O verdadeiro diferencial futuro provavelmente residirá em integração com ecossistema AWS, qualidade da documentação, comunidade e velocidade de adoção de novos modelos e padrões de agentes emergentes.
Fonte: MarkTechPost
Sobre o autor




