
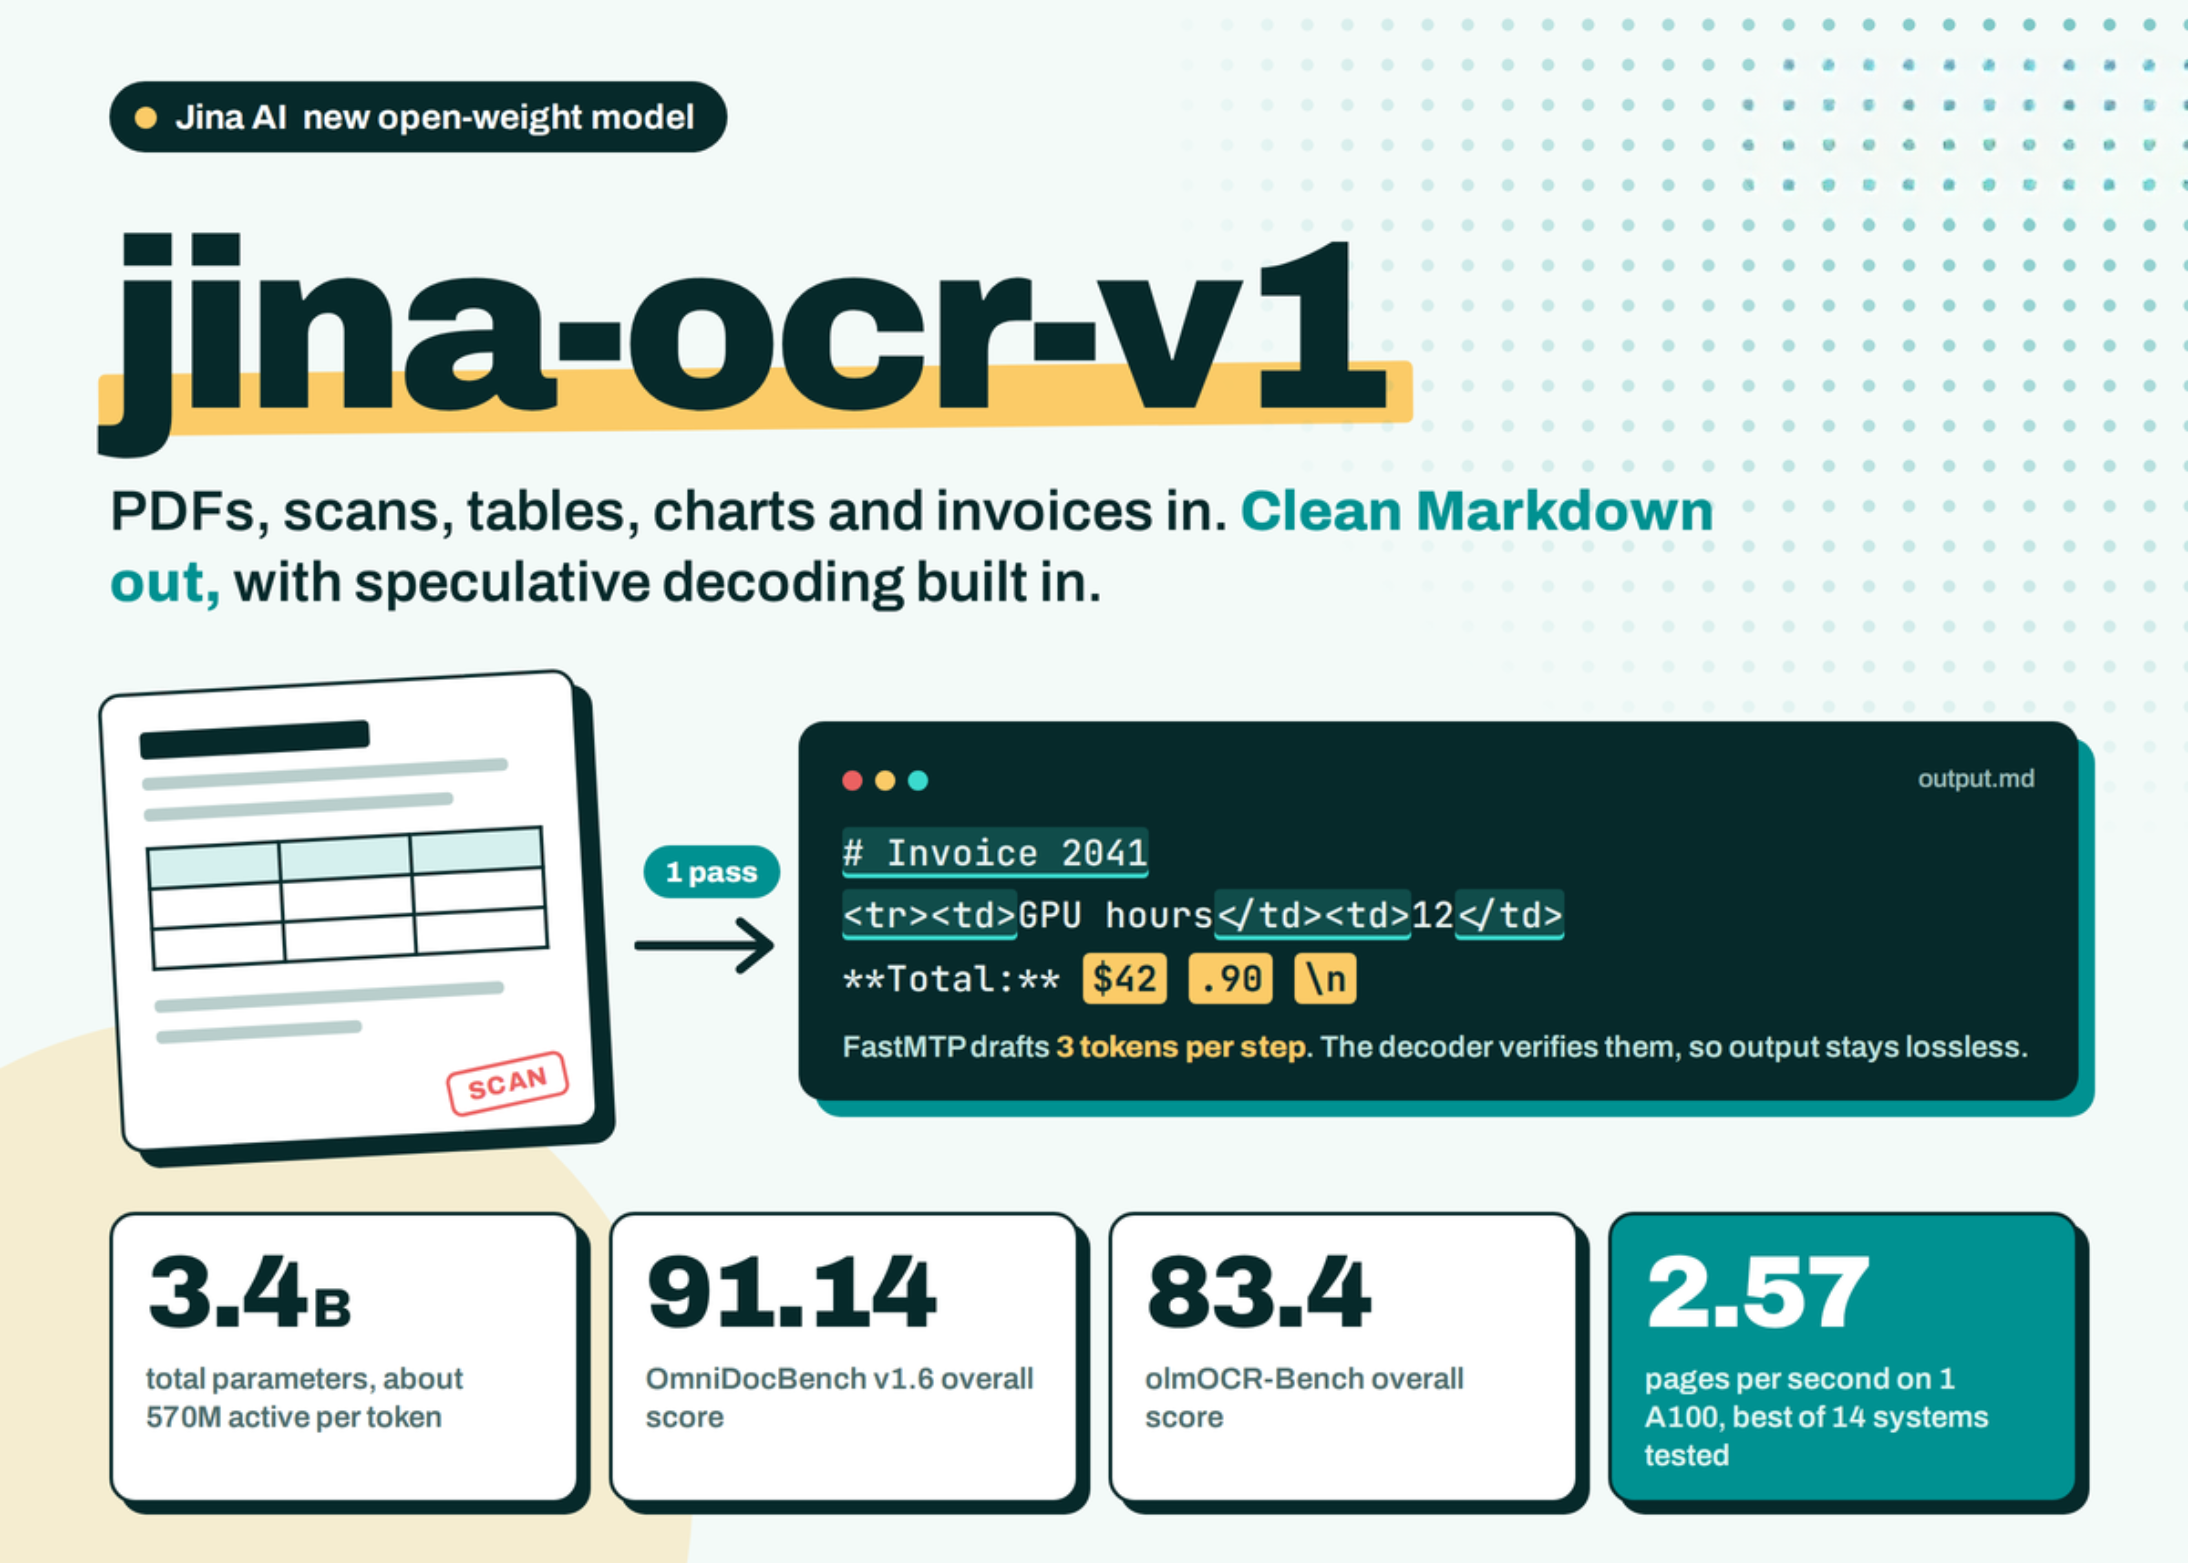
A Jina AI, divisão da Elastic, lançou o jina-ocr-v1, um analisador visual de documentos de código aberto que converte PDFs, digitalizações, tabelas, gráficos e faturas em Markdown limpo em uma única passagem. O modelo contém 3,4 bilhões de parâmetros totais, com aproximadamente 570 milhões ativos por token, e incorpora um cabeçalho de decodificação especulativa integrado para acelerar processamento em hardware com orçamento limitado, como a GPU NVIDIA L4.
Arquitetura e componentes técnicos
O jina-ocr-v1 constrói-se sobre o DeepSeek-OCR, mantendo seus dois componentes principais de eficiência. O DeepEncoder possui aproximadamente 380 milhões de parâmetros e encadeia SAM (Segment Anything Model), um compressor convolucional de 16x e CLIP-L. Esse componente converte uma visualização de página de 1.024×1.024 de 4.096 patches em 256 tokens visuais. Um modo de resolução dinâmica adiciona até 9 tiles locais com 100 tokens cada, limitando uma página a 1.156 tokens visuais.
O decodificador utiliza a arquitetura DeepSeek-3B-MoE com 12 camadas, 64 especialistas roteados e 2 especialistas compartilhados. O roteamento top-6 ativa aproximadamente 570 milhões de parâmetros por token, mantendo o processamento eficiente em hardware limitado. A saída é gerada em Markdown, com tabelas em HTML e fórmulas em LaTeX.
Um aspecto diferenciador é a inclusão de FastMTP, um cabeçalho de rascunho que aplica um bloco denso recursivamente durante K=3 etapas. O decodificador verifica os rascunhos de forma gulosa, aceitando o prefixo mais longo que corresponde às suas próprias escolhas e confirmando um token adicional. Se os 3 rascunhos coincidem, esse token extra é um bônus. O modelo confirma em média 2,73 tokens por etapa, mantendo a saída idêntica à decodificação gulosa pura, ou seja, a aceleração é sem perda.
Desempenho e throughput
Em testes de precisão, o jina-ocr-v1 alcança 91.14 em OmniDocBench v1.6 e 83.4 em olmOCR-Bench. Embora não seja líder em acurácia—PaddleOCR-VL-1.6 e HunyuanOCR-1.5 (94,74) pontuam mais alto em OmniDocBench—o modelo compensa com throughput superior. A pós-treinamento agregou 7,4 pontos ao benchmark olmOCR-Bench em relação ao backbone DeepSeek-OCR original.
Em uma GPU A100 de 40 GB com concorrência 32, o jina-ocr-v1 processa 2,57 páginas por segundo, a mais alta entre 14 sistemas medidos. Para comparação, olmOCR-2 alcança 1,22 páginas por segundo e chandra-ocr-2, 0,38. O modelo emite 1.085 tokens de saída por página, descrito como a produção mais curta entre sistemas que pontuam acima de 83 em olmOCR-Bench.
Em uma NVIDIA L4 com tamanho de lote 1, a decodificação especulativa (K=3) eleva a taxa de 42,7 para 83,1 tokens por segundo, uma aceleração de 1,95x com taxa de aceitação de 57,6%. Com CUDA graphs, o baseline já atinge 158,3 tokens por segundo, permitindo que K=1 funcione melhor a 185,6 tokens por segundo, um ganho de 1,17x.
- Resolução máxima de tokens visuais por página: 1.156 (256 padrão + até 900 locais)
- Limite de posição do modelo: 32.768 tokens
- Formatos de saída suportados: Markdown (padrão), HTML para tabelas, LaTeX para fórmulas
- Tamanho do checkpoint em BF16: aproximadamente 6,8 GB
Disponibilidade, licença e acesso
Os pesos abertos estão disponíveis no Hugging Face sob licença CC BY-NC 4.0, o que significa que uso comercial requer contato com a Jina AI. O modelo carrega em frameworks Transformers e vLLM, com FastMTP exigindo vLLM 0.21 ou posterior e um registro único.
A rota mais rápida para uso é o Jina Reader. Enviando uma URL para r.jina.ai com o cabeçalho X-Respond-With: jina-ocr-v1, o serviço busca a página ou PDF, executa o modelo e retorna Markdown. Um cabeçalho X-Page transcreve 1 página de um documento mais longo. A Jina AI também hospeda um endpoint compatível com OpenAI em https://api.jina.ai/v1/chat/completions, além de oferecer uma demonstração pública para testes rápidos.
Para auto-hospedagem, pesos e código customizado são fornecidos em um único repositório e carregam com trust_remote_code=True. O caminho Transformers executa apenas o decodificador MoE, ignorando os pesos do rascunho.
Treinamento e otimização de recompensa
A pós-treinamento combinou alinhamento por instrução, ajuste fino de robustez em páginas degradadas e GRPO (Group Relative Policy Optimization). Todos os termos de recompensa são códigos determinísticos pontuados contra uma transcrição de referência, cobrindo conteúdo, fórmulas, tabelas, validade estrutural, testes unitários, repetição e formato.
Os termos são multiplicados entre si, e cada um recebe nota parcial, permitindo que páginas parcialmente corretas ganhem crédito proporcional. Termos estruturais, de teste unitário e formato têm piso em 0,2, enquanto o termo de tabela fica em 0,1. O termo de repetição não tem piso, pois loops podem inflar a pontuação de conteúdo.
Como fórmulas e tabelas aplicam-se a poucos exemplos em páginas naturais, a Jina AI construiu JinaOCRSynth, um conjunto de páginas sintéticas repletas de ambas, cada uma com testes unitários estilo olmOCR-Bench. Um agente também mescla checkpoints candidatos sob um orçamento de avaliação fixo, treinando o cabeçalho de rascunho por último contra o verificador final congelado.
Análise Panorama IA
O lançamento do jina-ocr-v1 endereça um problema prático crítico na comunidade de IA aberta: extrair estrutura semântica de documentos visuais sem hardware costoso. Enquanto modelos OCR anteriores priorizavam acurácia em benchmarks tradicionais, Jina AI apostou em throughput e eficiência, uma escolha que reflete demandas reais em produção.
A decodificação especulativa integrada é particularmente relevante. Em vez de tratar o FastMTP como otimização bolted-on, o modelo o incorporou nativamente, mantendo saída lossless. Isso elimina a incerteza sobre degradação de qualidade—fator crítico para aplicações como processamento de faturas ou extração de contratos, onde um token faltante altera significativamente o resultado.
A comparação com alternativas revela nuances importantes: O jina-ocr-v1 não lidera em acurácia bruta, e a Jina AI comunicou isso transparentemente. PaddleOCR-VL-1.6 e HunyuanOCR-1.5 pontuam mais alto em OmniDocBench. Contudo, o ganho de velocidade (2,57 vs 1,22 páginas/s contra olmOCR-2) e a eficiência de tokens (1.085 tokens/página) criam um trade-off favorável para cenários de volume. Organizações processando milhares de documentos diariamente podem trocar precisão marginal por latência aceitável e custo de computação dramáticamente menor.
A licença CC BY-NC 4.0 é uma limitação operacional. Empresas que precisam monetizar aplicações OCR devem negociar com Jina AI ou procurar alternativas com permissividade comercial. Para pesquisa, startups não-comerciais e pipelines internos empresariais, o modelo oferece caminho viável de implementação.
Observar a evolução deste modelo será relevante: quanto a comunidade priorizará eficiência sobre acurácia marginal? A tendência de incorporar decodificação especulativa em modelos de visão deve acelerar, transformando a otimização de latência de problema downstream em requisito arquitetural. O jina-ocr-v1 demonstra que essa integração é viável sem comprometer saída determinística, um benchmark tecnológico que pode inspirar futuras versões de modelos concorrentes.
Fonte: MarkTechPost
Sobre o autor




